

Ringkasan Utama
Agent AI menulis migration yang valid secara SQL dan lolos di tabel test kosong, lalu mengunci tabel produksi. Review setiap diff migration dari sisi lock yang diambil tiap statement, bukan dari logikanya: ACCESS EXCLUSIVE memblokir bahkan SELECT biasa, ALTER yang mengantre memblokir semua yang ada di belakangnya, dan hanya expand-then-contract yang selamat di rolling deploy.
Migration itu hanya tiga statement dan ketiganya benar. Agent menambahkan kolom status, mengganti nama kolom yang sejak 2023 salah ketik menjadi ammount_cents, dan membuat index untuk mendukung filter baru — persis seperti yang saya minta, SQL-nya valid, dan jalan mulus di database test berisi dua belas baris. File yang sama dijalankan ke tabel dengan lebih dari 40 juta baris, dan API berhenti menjawab sebelum rolling deploy-nya selesai.
Ini review yang sekarang saya jalankan pada setiap diff migration, siapa pun atau apa pun yang menulisnya. Semua level lock dan perilaku yang bergantung versi di bawah ini saya cek ke manual PostgreSQL, bukan mengandalkan ingatan: bentuk ALTER TABLE mana yang mengambil ACCESS EXCLUSIVE, apa yang berhenti menulis ulang tabel di Postgres 11 dan 12, apa yang ditinggalkan oleh concurrent index build yang gagal, dan kenapa mengganti nama kolom dengan aman butuh empat deploy, bukan satu.
Review lock-nya, bukan logikanya
Review yang membaca SQL migration untuk mencari kesalahan logika akan meloloskan hampir semua yang ditulis agent, karena SQL-nya memang benar. Yang membedakan migration aman dari sebuah outage bukan apa yang dilakukan statement itu, melainkan lock apa yang diambilnya dan berapa lama dipegang. Manualnya menyatakan defaultnya dengan gamblang: ALTER TABLE mengambil lock ACCESS EXCLUSIVE kecuali sebuah subform disebut lain secara eksplisit, dan bila beberapa subcommand diberikan sekaligus, lock yang diambil adalah yang paling ketat di antara semuanya.
| Mode lock | Diambil oleh | Yang diblokir |
|---|---|---|
| ACCESS SHARE | SELECT biasa, dan query apa pun yang hanya membaca | Tidak ada, kecuali pemegang ACCESS EXCLUSIVE |
| ROW EXCLUSIVE | INSERT, UPDATE, DELETE | SHARE dan mode yang lebih ketat, bukan penulis lain |
| SHARE UPDATE EXCLUSIVE | CREATE INDEX CONCURRENTLY, VALIDATE CONSTRAINT, VACUUM | Perubahan schema dan vacuum lain, bukan read atau write |
| SHARE ROW EXCLUSIVE | ALTER TABLE ADD FOREIGN KEY, pada kedua tabel terkait | Penulis, bukan pembaca |
| ACCESS EXCLUSIVE | Hampir semua bentuk ALTER TABLE, DROP TABLE, TRUNCATE, VACUUM FULL | Semua mode lock lain, termasuk SELECT biasa |
Aturan lock paling ketat inilah yang sering membuat agent tersandung, karena menggabungkan beberapa perubahan ke dalam satu ALTER TABLE terlihat seperti optimasi, dan di tabel kecil memang begitu: alasan manualnya mengizinkan hal itu adalah agar beberapa scan atau rewrite menyatu menjadi satu lintasan. Di tabel besar, itu jebakan. ADD COLUMN yang murah dan duduk bersebelahan dengan ALTER COLUMN TYPE ikut mewarisi lock perubahan tipe itu beserta rewrite seluruh tabelnya, sementara diff-nya tetap terbaca sebagai satu statement yang rapi.
Lock yang ditunggu adalah lock yang menyakitkan
Sebagian besar outage migration bukan disebabkan oleh statement yang sedang berjalan, melainkan oleh statement yang sedang menunggu. ACCESS EXCLUSIVE bentrok dengan semua mode lock lain, jadi ALTER TABLE tidak bisa mulai selama masih ada transaction terbuka yang memegang bahkan sekadar ACCESS SHARE di tabel itu — SELECT analitik yang panjang, session psql yang terlupakan, atau koneksi yang idle di dalam sebuah transaction. Manualnya tegas soal apa yang terjadi berikutnya: transaction yang meminta lock di level tabel maupun baris akan menunggu tanpa batas sampai lock yang bentrok dilepas.
Itu masih bisa ditolerir kalau yang menunggu hanya dia sendiri. Kenyataannya tidak. PostgreSQL mengantrekan permintaan lock alih-alih memberikannya tidak berurutan, jadi setiap SELECT yang datang saat ALTER masih mengantre ikut berhenti di belakangnya, dan tabelnya tampak beku padahal migration-nya belum mengerjakan satu byte pun. Hanya lock ACCESS EXCLUSIVE yang memblokir SELECT biasa, dan itulah sebabnya kegagalan seperti ini adalah milik perubahan schema, bukan milik yang lain. Pertahanannya adalah menolak menunggu: batasi waktu tunggu dengan lock_timeout, lalu retry.
-- Every migration session starts with this. A migration that cannot get the
-- lock in three seconds is not "slow", it is queued in front of the whole
-- table, and every reader that arrives behind it is queued too.
SET lock_timeout = '3s';        -- a bare number means milliseconds, so name the unit
SET statement_timeout = '0';    -- lock_timeout at or above this would never fire

BEGIN;
ALTER TABLE invoices ADD COLUMN status text;   -- catalog write, lock held for milliseconds
COMMIT;
lock_timeout membatalkan statement apa pun yang menunggu lebih lama dari batas itu saat mencoba mengambil lock, dan batasnya berlaku terpisah untuk setiap percobaan pengambilan lock. Retry seluruh file, bukan statement-nya, karena pembatalan tadi me-rollback transaction yang membungkusnya. Lima percobaan dengan jeda yang membesar biasanya cukup. Kalau tidak cukup, bacaan jujurnya adalah ada sesuatu yang menahan transaction panjang, dan yang perlu diperbaiki bukan migration-nya.
#!/usr/bin/env bash
# Retry the FILE, not the statement. lock_timeout aborts one statement, and an
# aborted statement rolls back the transaction around it, so a half-applied
# migration is not a state you can be in. Back off; the blocker is transient.
set -euo pipefail

for attempt in 1 2 3 4 5; do
  if psql -v ON_ERROR_STOP=1 "$DATABASE_URL" -f 001_add_status.sql; then
    exit 0
  fi
  echo "attempt $attempt lost the lock race, backing off"
  sleep $(( attempt * 10 ))
done

echo "five attempts, still blocked. Something is holding a long transaction."
exit 1
Set kedua timeout untuk session migration, bukan di postgresql.conf — manualnya menyarankan tidak menyetelnya secara global karena akan memengaruhi semua session. Perhatikan juga interaksinya: kalau statement_timeout tidak nol, menyetel lock_timeout sama besar atau lebih besar jadi percuma, karena statement timeout akan selalu jatuh lebih dulu.
NOT NULL, dan apa yang benar-benar berubah di Postgres 11, 12, dan 18
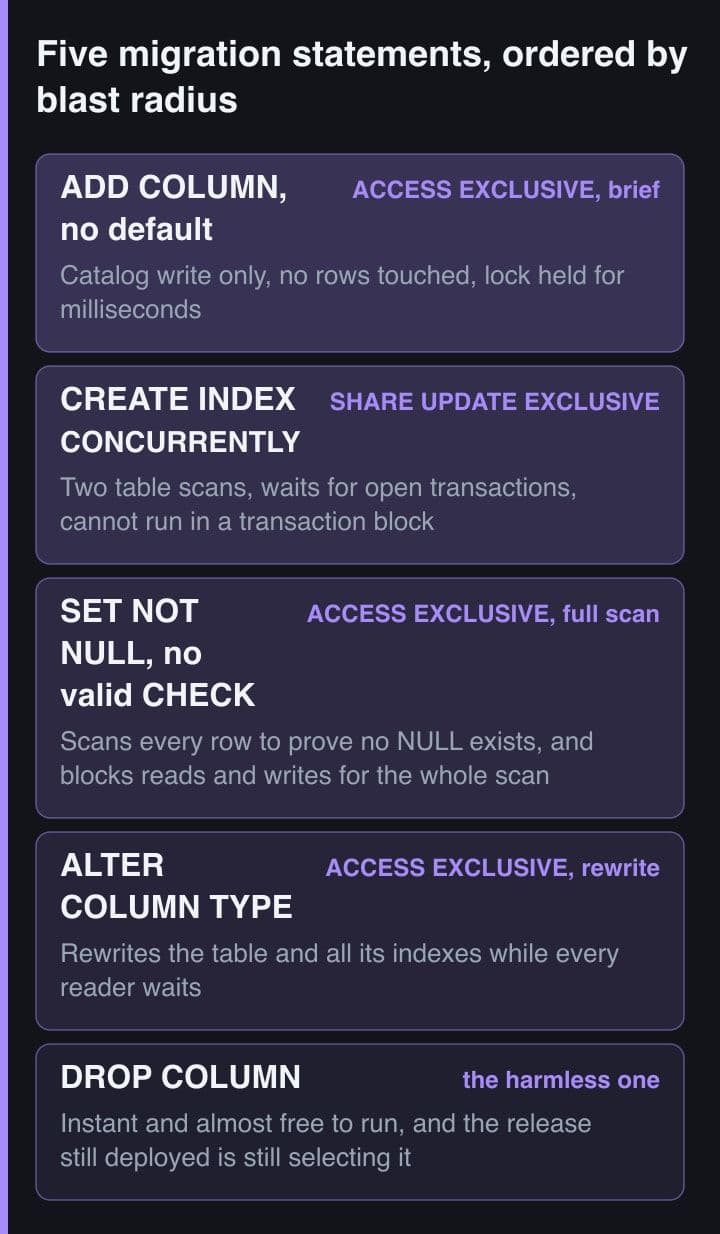
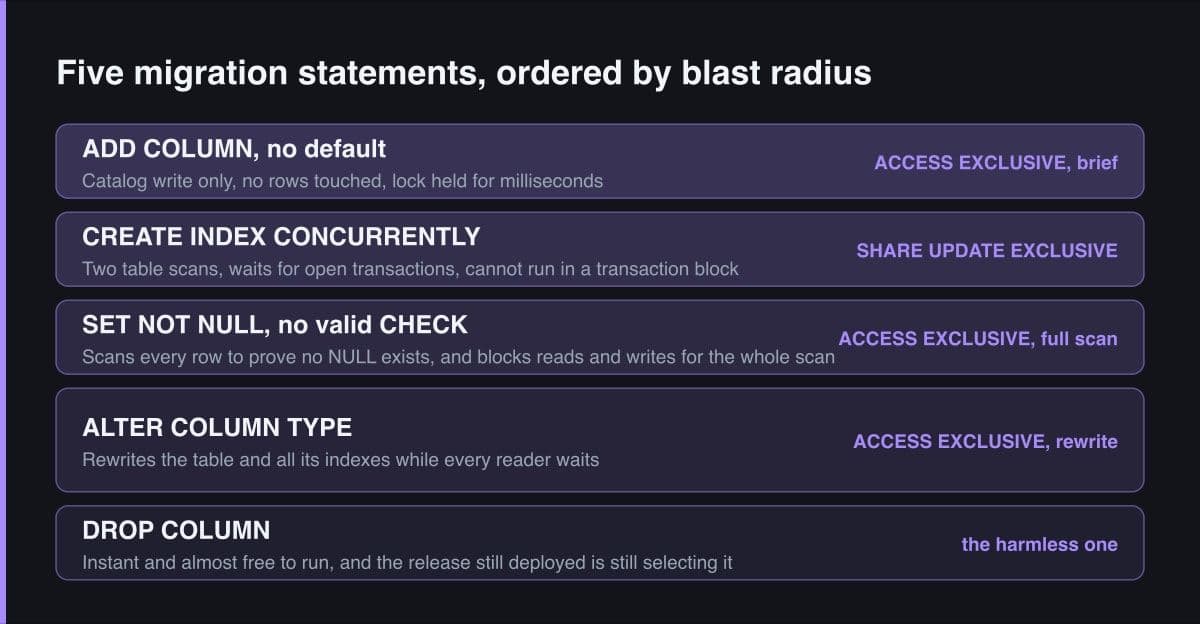
Bentuk yang paling sering saya terima dari agent adalah kolom baru yang NOT NULL dengan default, ditambahkan dalam satu statement. Di server yang cukup baru ini hampir gratis dan memang layak diloloskan: sejak Postgres 11, yang release notes-nya mencatat perubahan itu sebagai membolehkan penambahan kolom dengan default non-null tanpa rewrite tabel, nilai default dievaluasi sekali lalu disimpan di metadata tabel dan dikembalikan untuk baris lama saat dibaca. Yang dikecualikan manualnya dari jalur cepat itu justru bagian yang perlu diperiksa — default yang volatile seperti clock_timestamp, stored generated column, identity column, atau tipe domain yang membawa constraint tetap menulis ulang seluruh tabel beserta semua index-nya.
Menambahkan NOT NULL ke kolom yang sudah ada adalah kasus yang lebih berat, dan justru itu yang ditulis agent tanpa ragu. Statement itu mengambil ACCESS EXCLUSIVE dan memindai setiap baris untuk membuktikan tidak ada NULL: tanpa rewrite, tapi dengan full scan sementara read dan write terkunci selama scan berlangsung. Postgres 12 menambahkan jalan keluarnya, dan manualnya mendokumentasikan aturannya — kalau ada CHECK constraint yang valid yang membuktikan NULL tidak mungkin ada, dan constraint itu tidak ikut di-drop pada perintah yang sama, scan tabelnya dilewati.
-- Wrong on a large table: ACCESS EXCLUSIVE held for a scan of every row,
-- which means no reads and no writes until the scan finishes.
ALTER TABLE invoices ALTER COLUMN status SET NOT NULL;

-- Right: three statements, and the only slow one takes a lock writers ignore.
ALTER TABLE invoices
  ADD CONSTRAINT invoices_status_not_null
  CHECK (status IS NOT NULL) NOT VALID;          -- commits immediately, no scan

ALTER TABLE invoices
  VALIDATE CONSTRAINT invoices_status_not_null;  -- SHARE UPDATE EXCLUSIVE, scans,
                                                 -- does not lock out concurrent updates

ALTER TABLE invoices ALTER COLUMN status SET NOT NULL;
-- the scan is skipped: a valid CHECK already proves no NULL can exist
Statement di tengah itulah yang membuat urutan ini aman. Constraint yang ditambahkan sebagai NOT VALID langsung commit tanpa scan, dan mem-validate-nya kemudian hanya mengambil lock SHARE UPDATE EXCLUSIVE, yang tidak mengunci update yang sedang berjalan. Postgres 18 memperpendeknya lagi dengan membolehkan ALTER TABLE menyetel atribut NOT VALID pada not-null constraint secara langsung. Jalur mana yang berlaku bergantung pada versi server di produksi, bukan versi di laptop tempat migration-nya diuji, dan tidak ada agent yang bisa membaca itu dari repository Anda.
Kolom yang masih di-select oleh release yang sedang berjalan
Rolling deploy berarti dua versi aplikasi Anda berbicara ke satu database pada saat yang sama, selama rollout berlangsung. Jendela itulah yang tidak mungkin diketahui agent, dan itu sebabnya statement termurah dalam sebuah migration justru sering menjadi penyebab outage. Men-drop atau mengganti nama kolom adalah operasi katalog yang selesai dalam hitungan milidetik. Release lama, yang masih melayani trafik, terus meminta kolom yang sudah tidak ada.
-- What the PREVIOUS release is still sending while the new pods roll out.
-- No ORM selects a wildcard: it lists every column it has mapped, including
-- the misspelled one you just "fixed" in the same deploy.
SELECT "invoices"."id",
       "invoices"."customer_id",
       "invoices"."ammount_cents",
       "invoices"."created_at"
FROM "invoices"
WHERE "invoices"."id" = $1;

-- ERROR:  column invoices.ammount_cents does not exist
-- LINE 3:        "invoices"."ammount_cents",

-- The rename took an ACCESS EXCLUSIVE lock for about a millisecond.
-- The outage lasted as long as the rolling deploy did.
Ada baiknya membaca apa yang benar-benar dikirim ORM, karena bantahan yang biasa muncul — field itu sudah tidak kami pakai sejak berbulan-bulan lalu — sama sekali meleset dari mekanismenya. Entity yang dipetakan menghasilkan daftar kolom eksplisit, jadi kolom yang tidak pernah disebut kode Anda tetap ikut di setiap SELECT yang dikirim release sebelumnya. Solusinya bukan deploy yang lebih cepat, melainkan tidak pernah menghapus sesuatu di release yang sama dengan release yang berhenti memakainya.
Dua fakta kecil lain masuk ke review yang sama. Kolom yang di-drop tidak mengembalikan ruangnya: manualnya mencatat bahwa pengembalian ruang secara langsung menuntut salah satu bentuk ALTER TABLE yang menulis ulang tabel, jadi penghematan disk yang orang harapkan dari drop itu belum ada sampai ada yang menulis ulang tabelnya. Dan rename jelas lebih buruk daripada drop, karena ia merusak release lama dan release baru ke arah yang berlawanan pada saat yang sama — persis hal yang ingin dicegah oleh expand-then-contract.
CREATE INDEX tanpa CONCURRENTLY, dan invalid index yang ditinggalkannya
Index build biasa mengunci write di tabel, meski tidak mengunci read, sampai selesai. CONCURRENTLY menghindari itu dengan membangun index tanpa mengambil lock yang menghalangi insert, update, atau delete, dan manualnya cermat menyebut ongkosnya: dua kali scan tabel, menunggu transaction yang masih terbuka selesai sebelum tiap scan, kerja total yang jauh lebih banyak, dan hanya satu concurrent build per tabel pada satu waktu. Perintah ini juga tidak bisa dijalankan di dalam transaction block, dan justru detail itulah yang merusak migration tool, karena sebagian besar tool membungkus tiap file migration dalam satu transaction secara default.
-- CREATE INDEX CONCURRENTLY cannot run inside a transaction block, and most
-- migration tools wrap each file in one. Turning that wrapper off for this
-- file is the review item, not the CONCURRENTLY keyword.
CREATE INDEX CONCURRENTLY IF NOT EXISTS invoices_status_created_idx
  ON invoices (status, created_at DESC);

-- A concurrent build that fails leaves an INVALID index behind. It is ignored
-- for querying, still costs update overhead on every write, and a failed
-- unique build goes on enforcing its uniqueness. Look before you retry:
SELECT c.relname AS index_name, i.indisvalid
FROM pg_index i
JOIN pg_class c ON c.oid = i.indexrelid
WHERE NOT i.indisvalid;

-- Recovery is to drop it and build again, or REINDEX INDEX CONCURRENTLY.
DROP INDEX CONCURRENTLY IF EXISTS invoices_status_created_idx;
Mode kegagalannya adalah bagian yang belum pernah saya lihat disebut agent. Kalau build-nya kena deadlock atau pelanggaran uniqueness, CREATE INDEX gagal dan meninggalkan invalid index di katalog. Index itu diabaikan untuk query karena mungkin tidak lengkap, tetap membebani setiap write ke tabel, dan kalau ia unique index maka ia terus menegakkan uniqueness constraint-nya — jadi migration yang gagal bisa mulai menolak insert yang sah. Pemulihannya manual: drop index itu lalu bangun ulang, atau rebuild dengan REINDEX INDEX CONCURRENTLY.
Invalid index tidak mengumumkan dirinya. Query hanya tidak memakainya, jadi gejalanya berupa endpoint lambat yang baru ketahuan berminggu-minggu kemudian, ditambah beban write yang tidak bisa dijelaskan siapa pun. Taruh pengecekan pg_index di script setelah migration, bukan di ingatan Anda.
Backfill bukan satu statement
Hal terakhir yang diserahkan agent biasanya satu UPDATE yang mengisi kolom baru untuk semua baris. Statement itu benar, idempoten, dan di tabel besar ia yang paling mahal di seluruh file. PostgreSQL tidak langsung membuang versi lama dari baris yang di-update — begitulah cara MVCC bekerja — sehingga update ke seluruh tabel menulis versi baru untuk setiap baris dan meninggalkan satu versi mati di belakangnya.
Panduan manualnya soal kelanjutannya tidak ambigu: setelah aktivitas update besar-besaran, vacuum biasa bisa tidak memadai, dan mengembalikan ruangnya bisa menuntut VACUUM FULL atau CLUSTER, yang keduanya menulis ulang seluruh tabel. Ada ongkos kedua yang baru muncul di produksi. Seluruh update itu satu transaction, jadi ia commit sebagai satu ledakan WAL, dan setiap standby harus menerima lalu me-replay semuanya. Read replica tertinggal selama proses itu berlangsung, dan di situlah tiket soal data basi mulai berdatangan.
#!/usr/bin/env bash
# Backfill in bounded primary-key ranges. Each batch is its own transaction, so
# row locks are released as it goes and autovacuum can reclaim the dead row
# versions behind it instead of meeting all of them at the end.
set -euo pipefail

step=20000
lo=$(psql -At "$DATABASE_URL" -c "SELECT min(id) FROM invoices")
max=$(psql -At "$DATABASE_URL" -c "SELECT max(id) FROM invoices")

while [ "$lo" -le "$max" ]; do
  psql -v ON_ERROR_STOP=1 "$DATABASE_URL" -c "
    SET lock_timeout = '3s';
    UPDATE invoices SET status = 'draft'
     WHERE id >= $lo AND id < $lo + $step AND status IS NULL;"
  lo=$(( lo + step ))
  sleep 0.2   # give autovacuum and the replicas room between batches
done

# Do NOT batch with OFFSET. Each batch would re-scan and discard everything
# before it, so the job gets slower the further it gets. A key range does not.
Membaginya menjadi batch dengan rentang primary key yang terbatas memperbaiki keduanya. Setiap batch adalah transaction-nya sendiri, jadi row lock dan versi baris mati dilepas sambil jalan dan autovacuum bisa mengimbangi alih-alih bertemu seluruh tabel di akhir, dan WAL sampai ke replica dalam potongan yang bisa mereka replay di antara batch. Jeda antar batch sama pentingnya dengan ukuran batch. Backfill yang selesai dalam satu jam tanpa ada yang sadar lebih baik daripada yang selesai lima menit lalu membangunkan orang.
Expand lalu contract: satu rename adalah empat deploy
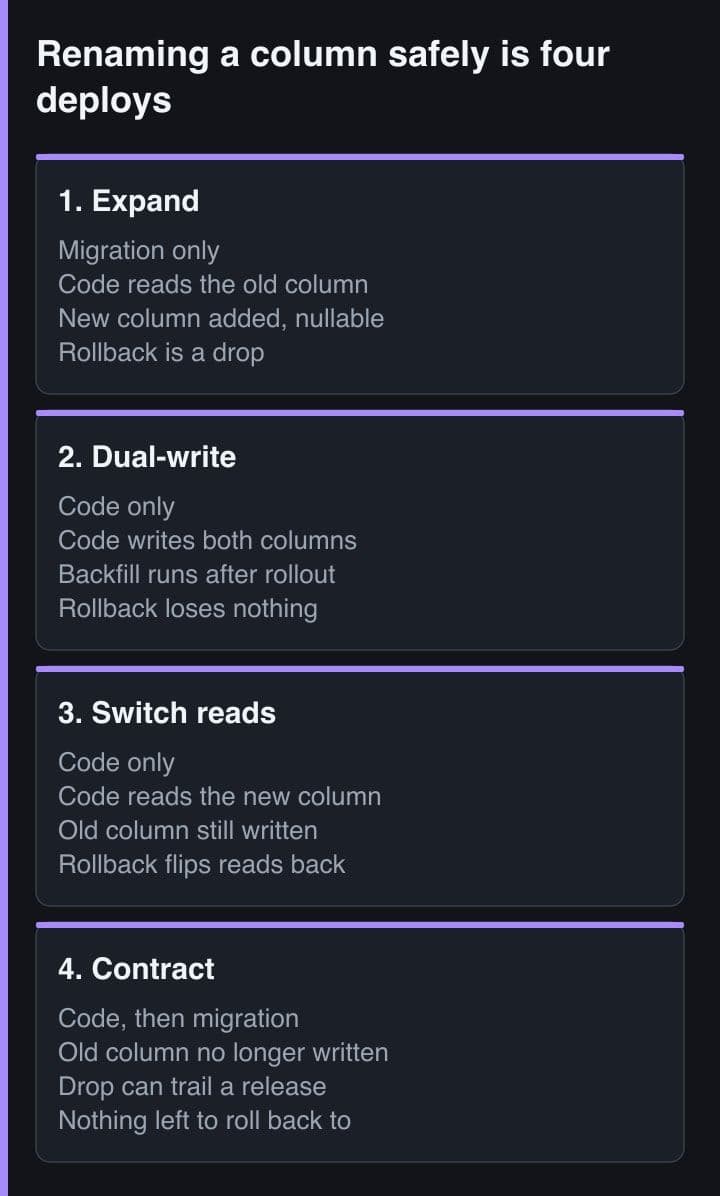
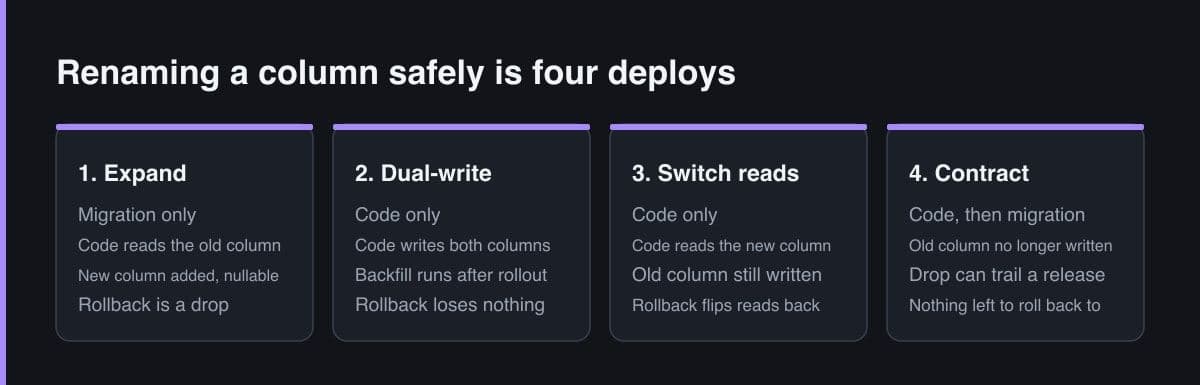
Semua kegagalan di atas berakar pada satu hal yang sama: migration dan kode yang bergantung padanya dikirim bersamaan. Expand-then-contract melepas kopling itu dengan membuat schema menampung bentuk lama dan bentuk baru sekaligus, sehingga tidak ada release yang sedang berjalan yang berbeda pendapat dengan database soal apa yang ada. Mengganti ammount_cents menjadi amount_cents adalah contoh klasiknya, dan melakukannya dengan aman butuh empat deploy.
- Deploy satu, hanya migration. Tambahkan amount_cents sebagai kolom nullable. Tidak ada yang membacanya, tidak ada yang menulisinya, dan rollback berarti men-drop kolom yang belum pernah disentuh kode mana pun.
- Deploy dua, hanya kode. Tulis kedua kolom pada setiap insert dan update. Setelah semua instance memakai release ini, jalankan backfill yang di-batch: baris baru sudah benar, jadi job-nya hanya perlu mengejar baris lama.
- Deploy tiga, hanya kode. Baca dari amount_cents, tetap tulis keduanya. Inilah cutover yang bisa dibalik — kalau angkanya terlihat salah, deploy berikutnya mengembalikan read ke kolom lama dan tidak ada yang hilang, karena kolom lama tetap dipelihara selama ini.
- Deploy empat, kode lalu migration. Berhenti menulis ammount_cents, pastikan tidak ada lagi yang merujuknya di codebase maupun di laporan mana pun, baru kemudian drop. Drop-nya boleh tertinggal satu release; menunggu tidak ada biayanya.
Empat deploy terdengar seperti seremoni sampai Anda menghitung apa yang dibeli masing-masing. Setiap langkah bisa dibalik sendiri-sendiri, dan tidak ada langkah yang menuntut schema dan release yang sedang berjalan sepakat soal sebuah nama pada detik yang sama. Backfill sengaja bukan sebuah deploy: ia job yang berjalan di antara dua deploy, bisa dihentikan dan dilanjutkan tanpa memblokir apa pun. Kalau sebuah perubahan tidak bisa dinyatakan dalam bentuk ini, itu sendiri sudah temuan, dan jauh lebih baik diketahui sebelum migration-nya jalan daripada saat sedang jalan.
Checklist yang saya jalankan pada setiap diff migration
Inilah yang sekarang saya tuntut dari sebuah migration, dan daftarnya sama saja entah manusia atau agent yang menulisnya. Butuh sekitar dua menit untuk satu diff, dan kira-kira satu dari tiga diff selalu menyisakan temuan.
- Lock apa yang diambil tiap statement, dan apakah ada subcommand yang menaikkan level lock untuk seluruh statement? Subcommand ALTER TABLE yang digabung mengambil lock paling ketat di antara mereka.
- Apakah session-nya menyetel lock_timeout, dan apakah file-nya aman dijalankan ulang dari awal setelah percobaan yang dibatalkan?
- Apakah ada yang memindai atau menulis ulang tabel — SET NOT NULL tanpa CHECK valid di belakangnya, ALTER COLUMN TYPE, default yang volatile, stored generated column, identity column?
- Apakah setiap index build memakai CONCURRENTLY, dengan pembungkus transaction milik tool dimatikan untuk file itu, dan apakah ada pengecekan setelahnya untuk invalid index yang tertinggal?
- Apakah diff-nya men-drop atau mengganti nama sesuatu yang masih di-select release yang sedang terpasang, termasuk kolom yang tidak lagi disebut kode tapi masih dipetakan ORM?
- Apakah backfill-nya di-batch dengan rentang key yang terbatas, satu transaction per batch, dengan jeda di antaranya?
Catatan jujur untuk menutup: agent sebenarnya jago soal ini, lebih jago dari yang ditunjukkan draft pertama tadi. Minta urutan expand-then-contract dengan menyebut namanya, beri tahu jumlah barisnya, versi server-nya, dan fakta bahwa deploy-nya rolling, maka yang kembali adalah empat file yang sudah mendekati benar, dengan index build yang sudah di luar transaction. Kegagalannya tidak pernah ada di SQL model itu, melainkan di permintaannya: saya meminta sebuah migration, dan sebuah migration itulah yang saya dapat.
Tiga fakta yang tidak bisa dibaca agent dari repository Anda justru menentukan aman tidaknya migration buatannya: berapa baris isi tabelnya, versi Postgres apa yang jalan di produksi, dan apakah deploy-nya rolling. Masukkan ketiganya ke dalam prompt, dan bentuk draft pertamanya akan berubah.
Aturan yang sekarang saya bawa cukup pendek untuk dipakai sambil membaca diff: sebuah migration aman kalau ia bisa berjalan tanpa disadari release yang sedang terpasang, dan selesai tanpa ada pembaca yang menunggu. Semua isi tulisan ini adalah cara menguji dua sifat itu. Review dari sisi lock dan dari sisi release yang satunya, maka siapa yang menulis SQL-nya jadi tidak lagi penting.
Sumber
- Manual PostgreSQL, ALTER TABLE — level lock, rewrite tabel, SET NOT NULL dan constraint NOT VALID
- Manual PostgreSQL, Explicit Locking — mode lock, apa yang bentrok dengan apa, dan perilaku menunggu
- Manual PostgreSQL, CREATE INDEX — membangun index secara concurrent dan invalid index yang ditinggalkan kegagalan
- Manual PostgreSQL, Client Connection Defaults — lock_timeout dan interaksinya dengan statement_timeout
- Manual PostgreSQL, Routine Vacuuming — versi baris mati akibat aktivitas update besar-besaran