

Ringkasan Utama
AI DevOps assistant mempersingkat triage Kubernetes dengan mengaitkan sebuah restart ke deploy sebelumnya dan menunjukkan stack trace yang berulang, tetapi ia tidak bisa melihat disk node yang penuh, kegagalan DNS di sisi upstream, atau secret yang sudah kedaluwarsa. Perlakukan jawabannya sebagai hipotesis, konfirmasi exit code sendiri, baru bertindak.
Halaman Helipod untuk Heli Crew mencantumkan pertanyaan yang memang diharapkan Anda ajukan: kenapa service saya mengembalikan 502, tampilkan error log terbaru, redeploy sekarang. Itu hampir sama dengan tiga hal pertama yang dilakukan siapa pun ketika sebuah pod mulai restart, dan chat box yang menjawab semuanya dari ponsel memang berguna. Namun dua di antaranya adalah pertanyaan dan yang ketiga adalah tindakan — dan jarak antara dua kategori itulah tempat triage dengan assistant mulai keliru.
Tulisan ini menilai kategori tool-nya, bukan mengulas satu produk. Saya belum menjalankan estate produksi di Helipod, jadi kemampuan yang saya sebutkan berasal dari daftar fitur mereka sendiri; perilaku Kubernetes berasal dari dokumentasi resminya, dan kebiasaan kerjanya berasal dari mengoperasikan cluster saya sendiri. Berikut apa yang benar-benar dipersingkat oleh assistant pembaca log, kelas kegagalan yang secara struktural tidak bisa ia lihat, dan di mana saya akan menempatkannya dalam sebuah urutan.
Yang dipersingkat adalah korelasi, bukan diagnosis
Hal paling berharga dari assistant semacam ini adalah menyusun kembali event dalam urutan waktu. Pod yang mulai restart empat menit setelah sebuah rollout hampir selalu disebabkan rollout itu, dan membuktikannya secara manual berarti membaca rollout history deployment, memeriksa image tag yang benar-benar dipakai pod yang berjalan, lalu menyejajarkan keduanya dengan restart count dan waktu terminasi terakhir. Assistant yang punya akses baca ke platform melakukan join itu dalam satu kalimat, saat Anda bahkan masih mencari namespace yang benar.
Korelasi adalah separuh triage yang murah, dan justru separuh yang paling sulit dilakukan manusia di bawah tekanan, karena tekanan itulah yang membuat Anda tidak sadar bahwa deploy pukul 13:41 dan restart pertama pukul 13:44 adalah satu peristiwa yang sama. Masalahnya, assistant menyampaikan sebuah kebetulan dengan nada yang sama seperti sebuah penyebab. Dua pod yang mulai gagal setelah rollout bisa jadi gagal karena disk sebuah node penuh saat rollout berjalan, dan kalimatnya terbaca sama saja.
Tiga baris yang benar-benar menentukan sebuah restart
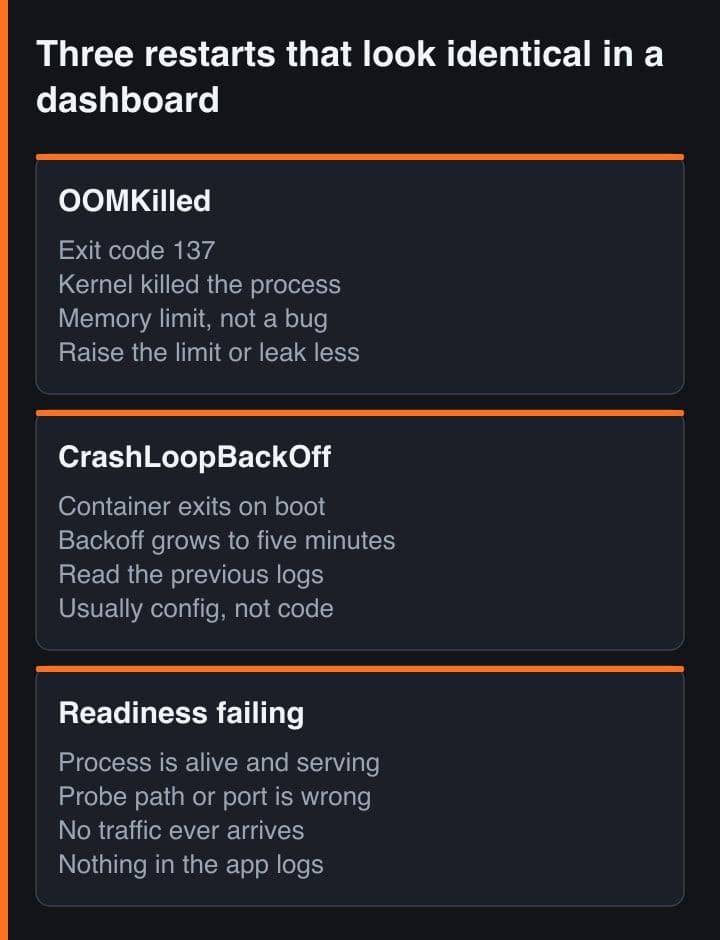
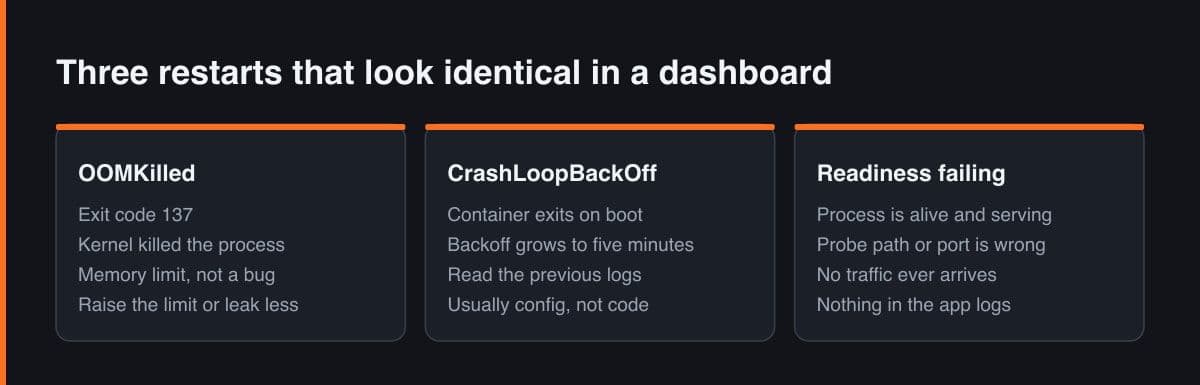
Ringkasan di chat akan dengan santai mengatakan aplikasi Anda crash. Pod-nya sendiri mengatakan sesuatu yang jauh lebih spesifik, dan hanya ada sedikit kalimat yang mungkin ia ucapkan. Ini output paling berguna di Kubernetes untuk dua menit pertama sebuah insiden, dan justru inilah yang tidak pernah dipelajari pembaca yang bergantung pada assistant.
$ kubectl describe pod checkout-7d9c8b6f5-2xk9m
...
    State:          Waiting
      Reason:       CrashLoopBackOff
    Last State:     Terminated
      Reason:       OOMKilled
      Exit Code:    137
      Started:      Fri, 04 Sep 2026 13:41:58 +0700
      Finished:     Fri, 04 Sep 2026 13:44:12 +0700
    Restart Count:  6
    Limits:
      memory:       512Mi

Events:
  Type     Reason     Age                From     Message
  ----     ------     ----               ----     -------
  Normal   Pulled     14m                kubelet  Container image "registry.internal/checkout:2026.09.04-1" already present on machine
  Warning  Unhealthy  9m (x4 over 12m)   kubelet  Readiness probe failed: HTTP probe failed with statuscode: 503
  Warning  BackOff    2m (x18 over 11m)  kubelet  Back-off restarting failed container

# Three things are true here and only one is the fault. CrashLoopBackOff is the
# waiting state, the readiness failure is what a dying container looks like from
# outside, and "OOMKilled / 137" is the sentence that decides what you fix.| Kata ringkasannya | Baris yang menentukan | Kenyataannya |
|---|---|---|
| Aplikasinya kehabisan memori | Reason OOMKilled, Exit Code 137 | Container mencapai memory limit-nya sendiri lalu di-kill. Menaikkan limit memang solusi, tetapi memory leak tetap memory leak. |
| Aplikasinya crash loop | State Waiting, Reason CrashLoopBackOff, Restart Count terus naik | Itu status backoff, bukan penyebab. Kubernetes sedang memberi jeda antar percobaan restart; penyebabnya ada di log container sebelumnya. |
| Container-nya dihentikan | Exit Code 143 tanpa alasan OOM | Ada yang meminta berhenti lewat SIGTERM — rollout, eviction, atau node drain. Sering kali bukan salah kode Anda. |
| Service-nya mati | Readiness probe failed, Restart Count tidak berubah | Container-nya hidup tetapi keluar dari endpoints Service, jadi tidak ada traffic yang sampai. Merestartnya tidak mengubah apa pun. |
| Deploy-nya gagal | ImagePullBackOff atau FailedScheduling, nol restart | Ia belum pernah berjalan, jadi tidak ada log aplikasi untuk diringkas — dan di sinilah assistant berbasis log paling lemah. |
Exit code 137 layak dihafal. Halaman dokumentasi memory limits milik Kubernetes sendiri menampilkan container yang berakhir dengan reason OOMKilled dan exitCode 137, yaitu 128 ditambah signal 9, SIGKILL. Dengan konvensi yang sama, container yang dihentikan lewat SIGTERM, signal 15, melaporkan 143 — dan SIGTERM adalah stop signal default untuk containerd maupun CRI-O, sehingga 143 biasanya berarti rollout, eviction, atau drain, bukan bug di kode Anda. Satu catatan yang ditulis jelas di dokumentasinya: runtime menghormati STOPSIGNAL yang dideklarasikan di image, jadi container dengan stop signal berbeda akan melaporkan angka berbeda.
Trace yang berulang, dan yang hanya muncul sekali
Di sini assistant benar-benar berguna. Dua belas ribu baris log dari container yang restart enam kali mungkin hanya berisi empat event yang berbeda, dan menemukannya dengan mata adalah bagian triage yang murni membosankan. Mengurutkan baris berdasarkan bentuknya, bukan berdasarkan posisi scroll, memang keahlian language model — dan itu juga bisa Anda lakukan sendiri dalam satu pipeline, yang sebaiknya Anda ketahui sebelum bergantung pada chat window.
# The chat answer was "repeated database connection errors". Twelve thousand
# lines of logs; the open question is whether that is one fault or three.

# --previous reads the container from BEFORE the last restart. The live one
# started 40 seconds ago and knows nothing about why its predecessor died.
kubectl logs checkout-7d9c8b6f5-2xk9m --previous --timestamps > prev.log

# Collapse the noise into shapes: drop the timestamp, fold ids and numbers,
# then count identical lines. This is the whole trick.
sed -E 's/^[^ ]+ //; s/[0-9a-f-]{30,}/ID/g; s/[0-9]+/N/g' prev.log \
  | sort | uniq -c | sort -rn | head

#   8231 ERROR pool: acquire timed out after Nms
#     14 WARN  retrying migration, lock held by session N
#      1 FATAL config: failed to decrypt secret, cipher key version N not found

# The 8231 is the symptom the summary led with. The line that occurred ONCE,
# first, and never again is the outage. Ranking by frequency buries it.
Jebakannya ada pada urutannya. Ringkasan log bukanlah log, dan baik model maupun pipeline uniq mengurutkan berdasarkan seberapa sering sebuah baris muncul, sementara baris yang menjelaskan sebuah outage justru sering muncul tepat sekali, di bagian awal, sebelum badai retry menutupinya. Karena itu saya juga meminta error pertama dan error paling jarang, bukan hanya yang paling sering. Yang paling sering biasanya cuma akibat.
Kemenangan sebenarnya ada pada orang yang belum pernah menjalankan kubectl describe
Argumen jujur untuk kategori ini bukan bahwa ia membuat operator berpengalaman lebih cepat, melainkan bahwa ia memberi developer tanpa latar belakang Kubernetes sebuah pintu masuk ke sistem yang kalau tidak begitu menolak menjelaskan dirinya sendiri. Helipod mencantumkan memeriksa CPU dan memori, menampilkan error log terbaru, dan membuat instance Redis sebagai hal yang cukup Anda minta di chat; bagi orang yang perkenalan pertamanya dengan cluster seharusnya berupa tembok output describe, itu benar-benar menurunkan biaya untuk sekadar melihat.
Fitur yang sama punya failure mode yang jelas: orang yang hanya pernah bertanya ke chat window tidak akan pernah tahu arti OOMKilled, dan assistant paling tidak bisa diandalkan justru ketika jawabannya tidak ada di log. Saya tetap lebih suka seorang engineer junior membaca ringkasan lalu membaca event-nya daripada tidak pernah membuka event sama sekali, jadi saya memposisikannya sebagai lapisan penerjemah di atas output yang tetap harus dibuka pembacanya.
Mintalah kandidat, bukan penyebab. Prompt seperti berikan tiga kemungkinan penyebab yang diurutkan dan kutip baris log atau event yang mendasari masing-masing menghasilkan sesuatu yang bisa Anda periksa dalam satu menit. Prompt seperti kenapa pod ini restart hanya menghasilkan satu kalimat penuh keyakinan tanpa bukti apa pun.
Ia tidak bisa melihat apa yang tidak pernah tercatat di log
Ini batas strukturalnya, dan model yang lebih pintar tidak menyelesaikannya. Assistant yang membaca stdout container Anda dan event platform hanya bisa menalar dari apa yang tertulis di sana. Tiga kegagalan produksi paling umum justru meninggalkan log aplikasi yang bersih: node yang disk-nya penuh lalu mulai melakukan eviction, nama upstream yang berhenti ter-resolve, dan credential yang kedaluwarsa pada tanggal yang tidak dicatat siapa pun di kalender. Ketiganya menghasilkan error di level aplikasi yang menggambarkan gejalanya dengan akurat tetapi menunjuk komponen yang salah.
# 1. The node, not the pod. Check this first when several unrelated
#    workloads degrade in the same minute.
kubectl get nodes -o wide
kubectl describe node worker-3 | sed -n '/Conditions:/,/Addresses:/p'
#   DiskPressure   True   KubeletHasDiskPressure   image garbage collection failed

# 2. Cluster events, oldest first. Evictions, FailedMount and FailedScheduling
#    never appear in your container's stdout, so they never reach the summary.
kubectl get events -A --sort-by=.lastTimestamp | tail -20

# 3. Resolution and reachability from inside the cluster. An upstream DNS
#    failure and "the payments API is down" produce the same client-side error.
kubectl run netcheck --rm -it --restart=Never --image=busybox:1.36 -- \
  sh -c 'nslookup payments.internal; wget -qO- -T3 http://payments.internal/healthz'

# 4. Credentials, which fail on a calendar rather than on a deploy.
kubectl get secret payments-client -o jsonpath='{.metadata.annotations}'
Yang terjadi berikutnya mudah diduga. Ketika ditanya kenapa sebuah pod tidak sehat, assistant menyalahkan aplikasi, karena log aplikasi adalah satu-satunya saksi yang ia wawancarai. Ia menyarankan menaikkan memori untuk masalah node, atau retry untuk masalah DNS. Saran itu tidak bodoh — itu inferensi terbaik dari bukti yang ia punya, dan justru karena itu operatornya harus membawa bukti yang tidak ia punya.
Yakin, salah, dan sambil memegang tombol restart
Bagian dari kategori ini yang paling saya perlakukan hati-hati adalah bahwa assistant generasi baru tidak hanya menjelaskan, tetapi juga bertindak. Heli Crew dideskripsikan bisa deploy, restart, memeriksa log, dan debug langsung dari chat, dan redeploy sekarang adalah salah satu prompt yang mereka iklankan. Diagnosis salah yang hanya menghasilkan kalimat membuat Anda kehilangan satu menit. Diagnosis salah yang disertai restart membuat Anda kehilangan buktinya, karena log container sebelumnya adalah tempat penyebabnya tertulis, dan setiap restart mendorongnya satu generasi lebih jauh.
- Ia menjawab dengan nada seyakin itu baik ketika buktinya stack trace maupun ketika itu hanya dugaan, dan tidak ada apa pun di jawabannya yang membedakan keduanya.
- Ia menyalahkan aplikasi Anda untuk masalah platform, karena log aplikasi Anda adalah satu-satunya saksi yang ia wawancarai.
- Ringkasannya adalah kompresi log yang lossy, dan baris yang ia buang bisa jadi baris yang Anda butuhkan.
- Ia bisa bertindak atas diagnosisnya sendiri, dan restart yang dijalankan atas penyebab yang salah menghapus generasi log yang menyimpan penyebab yang benar.
Sebelum Anda mengizinkan assistant merestart apa pun, ambil dulu log container sebelumnya sendiri. Flag --previous pada kubectl logs membaca salinan dari sebelum restart terakhir, dan itu satu-satunya tempat kegagalan awal terekam. Restart di atas restart membuatnya hilang untuk selamanya.
Urutan triage dengan assistant di tengah
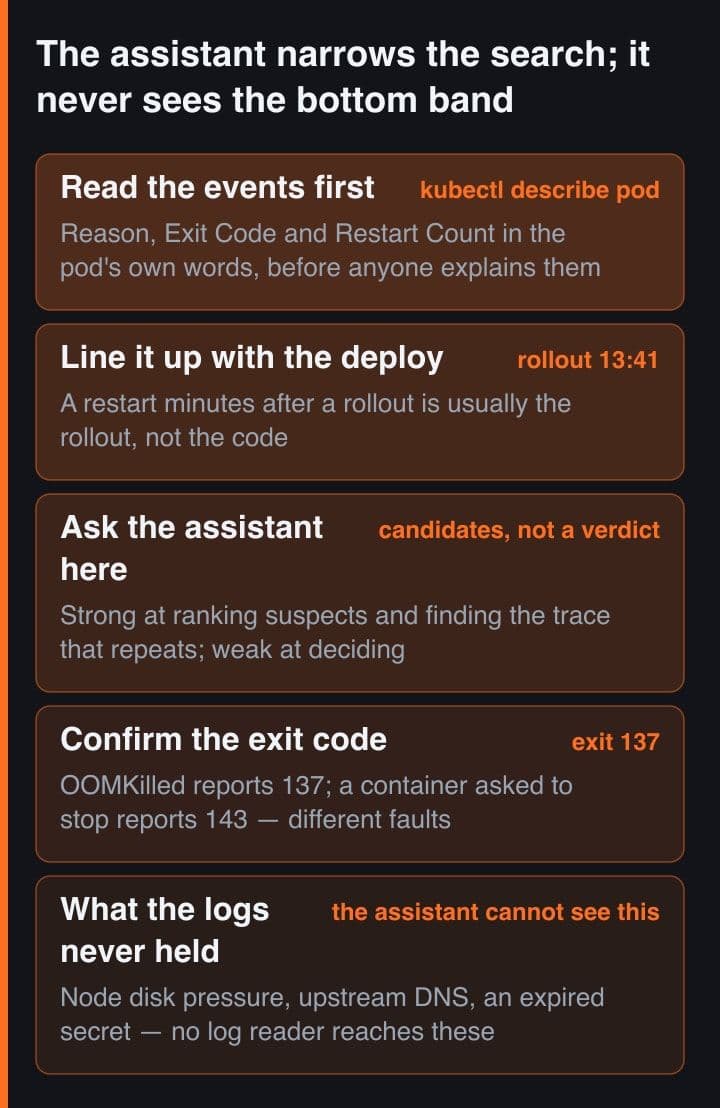
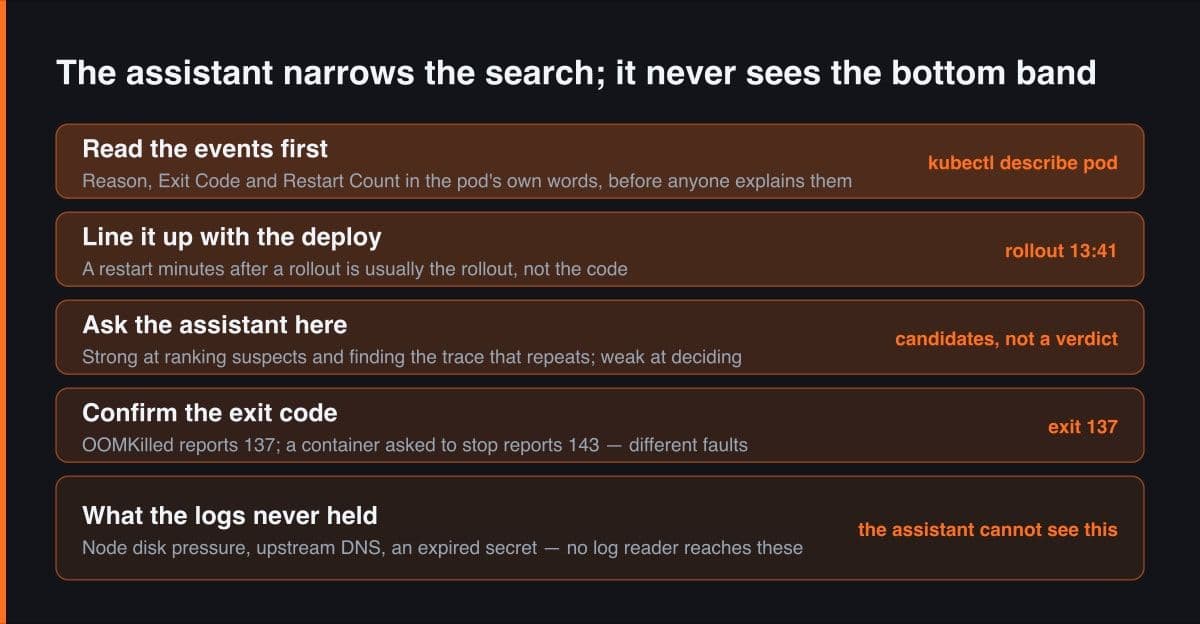
Ini urutan yang saya pakai, dan satu-satunya aturan yang benar-benar penting adalah assistant tidak boleh menjadi langkah pertama maupun langkah terakhir. Ia datang setelah bukti mentah, karena model yang sudah membaca event jauh lebih baik daripada model yang menduga dari sebuah pertanyaan, dan sebelum tindakan, karena tindakan membutuhkan penyebab yang sudah dikonfirmasi.
- Pastikan apa yang berubah. Rollout history dan image tag yang benar-benar berjalan menjawabnya dalam dua perintah, dan deploy adalah penyebab yang paling mungkin sekaligus paling murah untuk dieliminasi.
- Baca sendiri event-nya: Reason, Exit Code, dan Restart Count, dalam kata-kata pod itu sendiri, sebelum ada yang menjelaskannya kepada Anda.
- Baru tanya assistant, dengan event dan log container sebelumnya ikut di dalam prompt, dan minta kandidat berperingkat, bukan sebuah penyebab.
- Uji kandidat teratasnya dengan bukti yang tidak pernah ia lihat — kondisi node, event seluruh cluster, resolusi nama dari dalam namespace, dan umur secret-nya.
- Bertindak, lalu tulis exit code dan penyebab yang sudah dikonfirmasi ke catatan insiden. Catatan itulah yang membuat kejadian kedua selesai dalam dua menit.
# 1  What changed. Most common cause, cheapest to rule out, and the one
#    question the assistant answers well — so ask it here, not for a verdict.
kubectl rollout history deployment/checkout
kubectl get pod -l app=checkout -o jsonpath='{.items[*].spec.containers[*].image}'

# 2  What the cluster saw, in its own words, before anyone explains it.
kubectl describe pod -l app=checkout \
  | grep -E 'Reason:|Exit Code:|Restart Count:|Readiness probe'

# 3  Now ask the assistant. Give it the events and the previous container's
#    log, and ask for RANKED CANDIDATES with the line each one rests on.

# 4  Test its top candidate against something it did not read.
#    "out of memory"    -> kubectl top pod, plus the container's own limits
#    "bad config"       -> kubectl get configmap/secret, and the mounted value
#    "upstream is down" -> resolve and curl the dependency from the namespace

# 5  Only now act, and record the exit code in the incident note. Next time,
#    "137 again, same node" is the fastest sentence you own.
kubectl rollout undo deployment/checkout
Langkah dua dan empat adalah yang paling sering dilewati orang, dan justru keduanya yang menjaga assistant tetap jujur. Langkah dua memberinya bukti nyata untuk ditalar, bukan sebuah pertanyaan; langkah empat adalah satu-satunya penghalang antara kalimat yang terdengar masuk akal dan perubahan produksi yang dilakukan atas dasar kalimat itu.
Aturan yang akan saya berikan kepada siapa pun yang mulai memakai assistant seperti ini sempit saja: biarkan ia memberi tahu ke mana harus melihat, jangan pernah apa yang harus disimpulkan. Ia indeks yang sangat bagus ke dalam aliran log dan penerjemah yang sangat bagus untuk kosakata Kubernetes, dan ia secara struktural buta terhadap node, jaringan, dan kalender. Baca event-nya, konfirmasi exit code-nya, dan biarkan chat window jadi langkah yang menghemat scroll Anda.
Sumber
- Kubernetes — Assign Memory Resources to Containers, yang menampilkan reason OOMKilled dengan exitCode 137
- Kubernetes — Pod Lifecycle: CrashLoopBackOff, backoff restart, dan stop signal SIGTERM
- Kubernetes — Liveness, Readiness, dan Startup Probes
- signal(7), manual page Linux: SIGKILL adalah signal 9 dan SIGTERM adalah signal 15
- Helipod — Heli Crew, AI DevOps assistant milik platform itu dan prompt yang mereka iklankan