

Ringkasan Utama
Agent AI yang diminta menulis test akan meng-assert apa yang saat ini dilakukan implementasi, jadi coverage naik sementara verifikasi tidak. Mutation testing membongkarnya: rusakkan satu baris dengan sengaja lalu lihat apakah ada test yang gagal. Mutant yang survived menandai kode yang covered tapi tidak terverifikasi. Perbaiki akarnya dengan memberi agent spesifikasi, bukan kodenya.
Modul itu adalah approval router di sebuah ERP, angka coverage-nya sudah memalukan selama setahun, dan saya minta agent membenahinya. Agent membaca file-nya, menulis empat puluh satu test, dan semuanya lulus pada run pertama. Dua minggu kemudian sebuah nominal tepat lima puluh juta masuk ke approver yang salah, pada boundary yang justru diuji secara eksplisit oleh tiga test baru itu.
Test-test itu bukan asal-asalan. Test-test itu sirkular, dan itu kegagalan yang berbeda serta jauh lebih sunyi: test yang diturunkan dari implementasi tidak mungkin mendeteksi bahwa implementasinya salah, karena jawaban yang salah sudah dicatat sebagai nilai yang diharapkan. Tulisan ini membahas mekanismenya, empat bentuknya dalam kode nyata, tool yang menangkapnya, biaya jujur menjalankan tool itu, dan satu instruksi di prompt yang menghentikan seluruh pola ini.
Test yang ditulis dari kode tidak bisa menilai kode itu
Minta agent menguji sebuah file, dan agent akan membaca file itu. Satu fakta itu melahirkan semua sisanya. Nilai yang diharapkan di dalam test yang dikembalikannya adalah nilai yang dihasilkan kode, karena kode itulah satu-satunya sumber kebenaran yang diberikan kepadanya, sehingga suite-nya hijau secara struktural. Suite itu juga akan hijau untuk implementasi lain, selama implementasi itulah yang dibacanya.
// src/approval/level.ts
//
// Requirement, from the approval matrix in the spec:
//   level 1 up to and including 10,000,000
//   level 2 above 10,000,000 up to and including 50,000,000
//   level 3 above 50,000,000
//
// The implementation below is WRONG at both boundaries: it uses > where the
// requirement says "up to and including", so an amount of exactly 50,000,000
// routes to level 2 instead of level 3. One character per branch.
export function approverLevel(amount: number): number {
  if (amount > 50_000_000) return 3;
  if (amount > 10_000_000) return 2;
  return 1;
}
Perhatikan apa yang bisa dan tidak bisa dilakukan suite semacam itu. Ia bisa memaku behaviour saat ini, jadi refactor berikutnya yang mengubah routing akan tertangkap, dan itu ada nilainya. Ia tidak bisa memberi tahu Anda bahwa routing-nya sudah salah sejak hari test itu ditulis. Yang Anda punya adalah regression net di sekeliling sebuah defect, bukan pemeriksaan terhadap requirement, dan tidak ada dashboard CI yang membedakan keduanya.
Empat bentuk yang lulus apa pun isi kodenya
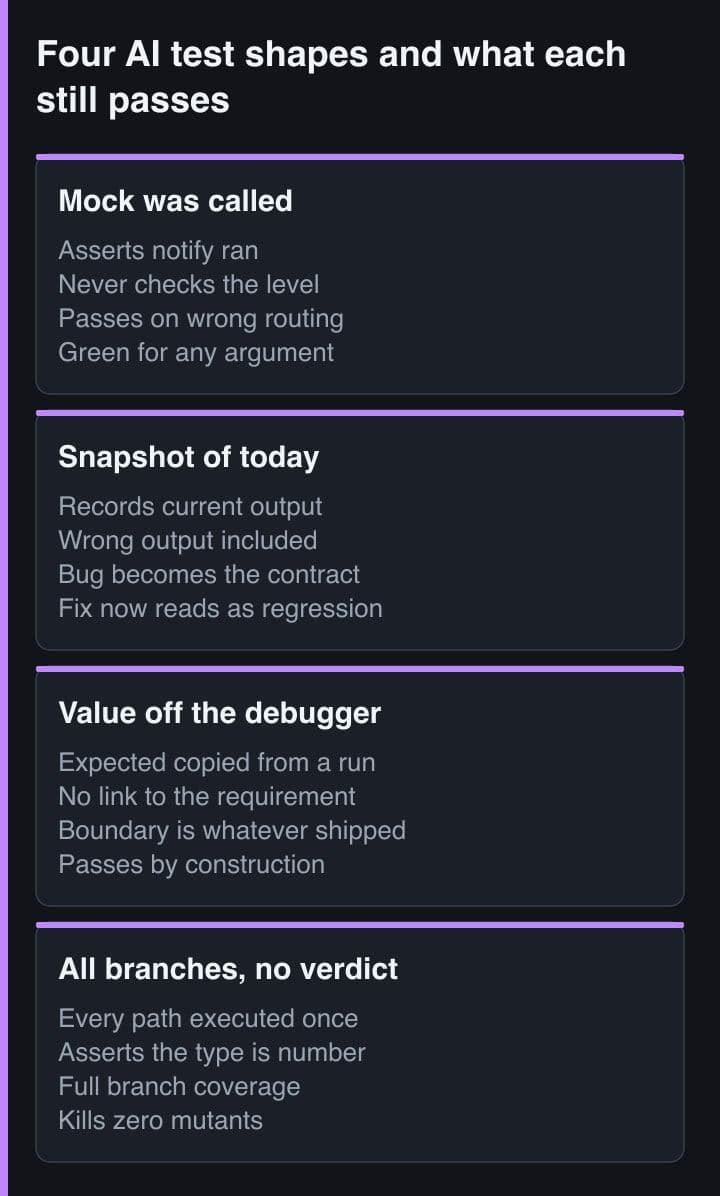
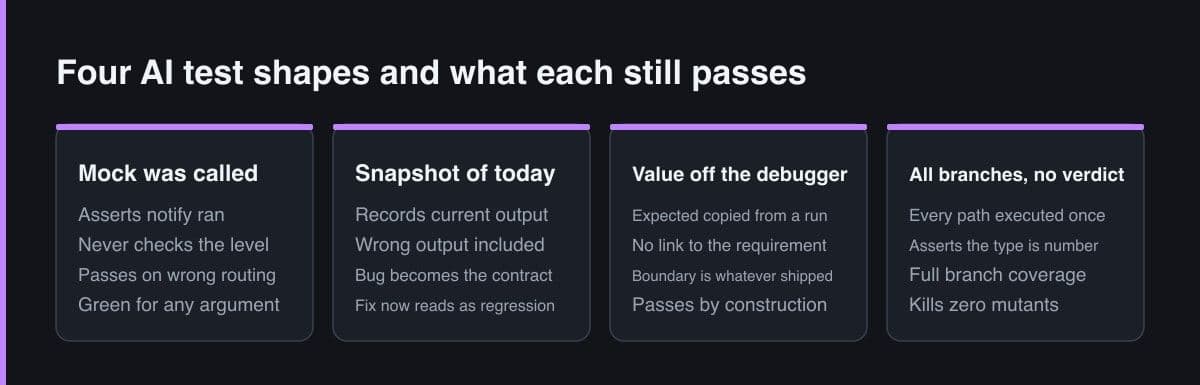
Begitu tahu apa yang harus dicari, test seperti ini langsung terbaca saat review. Empat bentuk mencakup hampir semua yang pernah saya kembalikan, dan keempatnya ditulis di bawah ini terhadap function yang sama yang sudah rusak itu.
// Shape 1 — asserts the mock was called, not what came out.
it("notifies the approver", () => {
  const notify = vi.fn();
  routeForApproval(50_000_000, notify);
  expect(notify).toHaveBeenCalled();
  // Called with what? Routed to which level? The assertion cannot tell,
  // so it holds for every possible routing decision, correct or not.
});

// Shape 2 — snapshots today's output, wrong output included.
it("matches the approval snapshot", () => {
  expect(approverLevel(50_000_000)).toMatchInlineSnapshot("2");
  // 2 is what the code returns. The requirement says 3. The snapshot has
  // just promoted the bug to the contract, and the eventual fix will look
  // like a regression that needs re-recording.
});

// Shape 3 — expected value read off a run, not derived from the requirement.
it("returns level 2 at fifty million", () => {
  expect(approverLevel(50_000_000)).toBe(2);
  // This is the tell: the test asserts 2 because someone observed 2.
  // Nothing in this file ever consulted the approval matrix.
});

// Shape 4 — every branch executed, nothing meaningful asserted in any of them.
it.each([5_000_000, 20_000_000, 80_000_000])("handles %i", (amount) => {
  expect(typeof approverLevel(amount)).toBe("number");
  // Three cases, all three branches, full branch coverage on the module,
  // and not one statement about which level is correct.
});
Sifat yang sama-sama mereka miliki: tidak satu pun menyebut hasil yang dituntut requirement. Bentuk 1 meng-assert bahwa sebuah call terjadi, bentuk 2 meng-assert output sama dengan dirinya sendiri, bentuk 3 meng-assert angka yang tidak diturunkan siapa pun, dan bentuk 4 meng-assert sebuah type. Ganti aturan routing-nya dengan versi lain yang masuk akal, keempatnya tetap lulus. Itu bukan suite yang lemah, itu suite yang sama sekali tidak berpendapat.
Inline snapshot adalah yang paling mahal dari keempatnya, karena ia membela bug secara aktif. Setelah nilai yang salah terekam, perbaikan yang benar justru membuat test gagal, dan jalan tercepat kembali ke hijau adalah merekam ulang snapshot-nya. Saya pernah melihatnya di sebuah review: perbaikan satu baris, snapshot yang diperbarui di commit yang sama, dan pipeline hijau yang mengesahkan defect aslinya.
Coverage menghitung eksekusi, bukan verifikasi
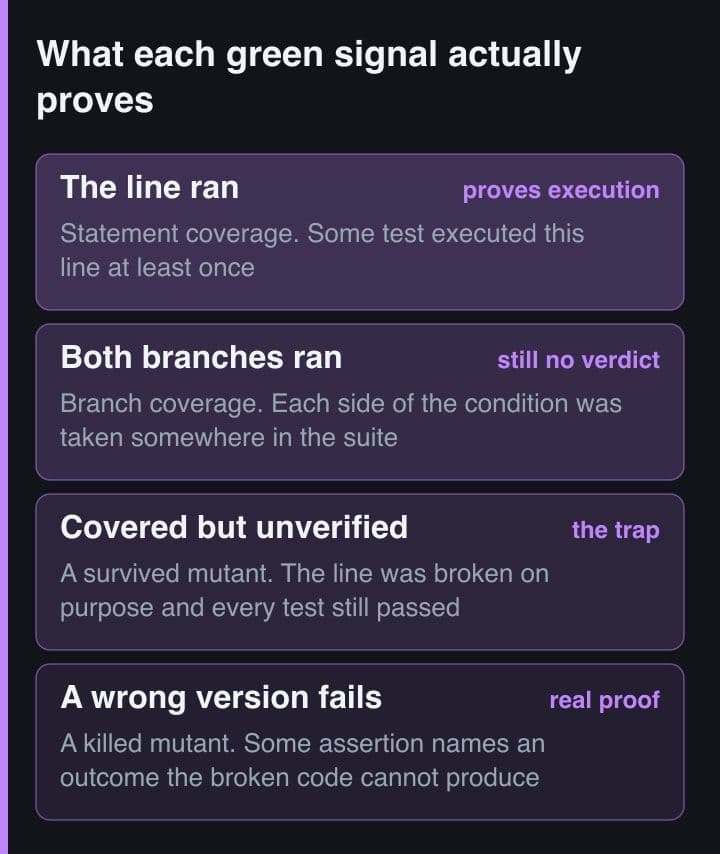
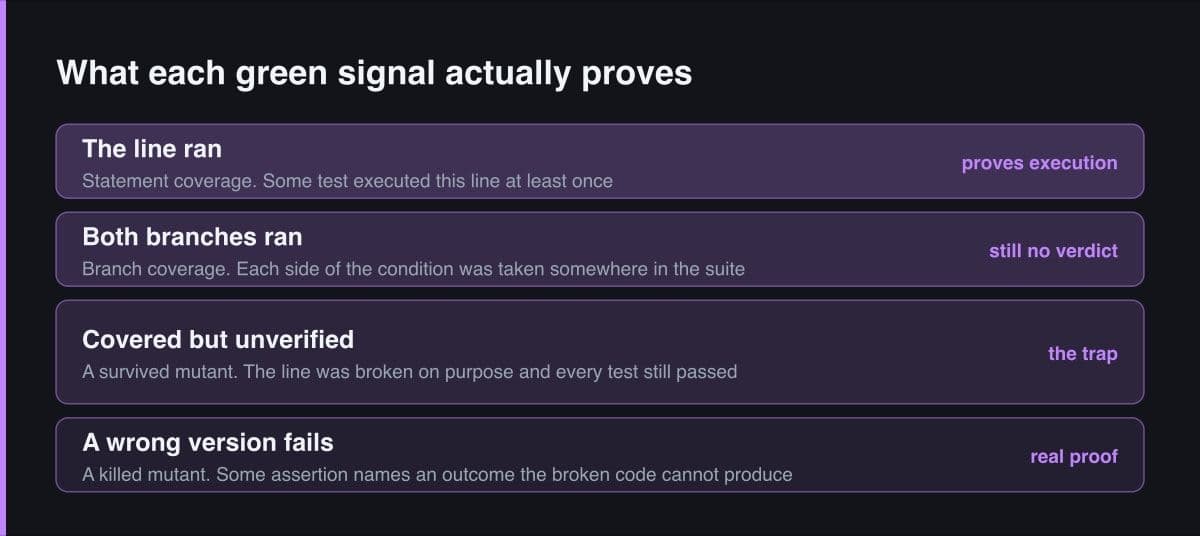
Coverage tidak bisa mendeteksi semua ini, dan bukan karena tool-nya lemah. Itu memang definisi metriknya. Bentuk 4 mengeksekusi setiap baris dan kedua sisi setiap condition di function itu sambil hanya meng-assert bahwa return type-nya berupa number, jadi ia dapat nilai penuh di kedua counter. Tiga sifat definisi ini layak dibaca lambat-lambat, karena bersama-sama itulah alasan dashboard Anda terlihat bagus:
- Statement coverage menjawab apakah sebuah baris dieksekusi selama run. Ia tidak punya akses ke assertion di dalam test yang mengeksekusinya, dan tidak bisa digerakkan olehnya.
- Branch coverage menjawab apakah kedua sisi sebuah condition pernah diambil di suatu tempat dalam suite. Tidak ada yang mewajibkan satu test tunggal membedakan kedua jalur itu satu dari yang lain.
- Kedua counter tidak bisa membedakan test yang meng-assert approval level yang benar dari test yang meng-assert hasilnya berupa number, karena assertion bukan input bagi salah satu perhitungan itu.
Jadi sebuah modul bisa duduk di puncak kedua counter dengan defect di setiap branch, dan angkanya tidak berbohong. Angka itu menjawab pertanyaan yang berbeda dari yang Anda ajukan padanya. Pertanyaan yang sebenarnya Anda punya adalah apakah versi yang salah dari kode ini akan membuat suite gagal, dan tidak ada bagian dari coverage report yang menyentuh itu.
Mutation testing: rusakkan kodenya, lihat siapa yang sadar
Ada pengukuran untuk pertanyaan yang tidak dijawab coverage. Rusakkan kodenya dengan sengaja lalu lihat apakah ada test yang gagal. Tool-nya membuat satu perubahan kecil yang tetap valid secara sintaks pada source, membalik sebuah perbandingan, menggantikan sebuah condition dengan true, mengosongkan sebuah string literal, lalu menjalankan suite terhadap salinan yang sudah diubah itu. Setiap salinan itu disebut mutant. Kalau ada test yang gagal, mutant itu killed, dan Anda punya bukti bahwa ada assertion yang bergantung pada baris itu benar. Kalau semua test lulus, mutant itu survived.
// stryker.config.json — scope it to one module, never the whole repo
{
  "packageManager": "npm",
  "testRunner": "vitest",
  "mutate": ["src/approval/**/*.ts"],
  "reporters": ["clear-text", "progress", "html"],
  "incremental": true
}

// npx stryker run
//
// Stryker rewrites the module once per mutant and re-runs the suite. Two of
// the mutants it generates for approverLevel, from its ConditionalExpression
// and EqualityOperator mutators:
//
//   - if (amount > 50_000_000) return 3;
//   + if (true) return 3;
//
//   - if (amount > 10_000_000) return 2;
//   + if (amount >= 10_000_000) return 2;
//
// Against the four tests above, both SURVIVE — Stryker's definition of
// survived is that all tests passed while the mutant was active. Line and
// branch coverage on this file read the same the whole time. The second
// mutant is the interesting one: it is the boundary bug injected on the
// other branch, and the suite has no opinion about that either.
Survived adalah status yang penting, dan dokumentasi Stryker berhati-hati memisahkannya dari status yang mereka sebut no coverage. Mutant no coverage tidak pernah dieksekusi test mana pun. Mutant survived dieksekusi oleh test yang tidak peduli pada hasilnya, dan itu persis yang diproduksi agent dalam skala besar. Angka utamanya, mutation score, adalah mutant yang terdeteksi dibagi mutant yang valid, dan berbeda dengan coverage, angka itu tidak bisa dinaikkan hanya dengan mengeksekusi lebih banyak kode.
Tool-nya, dan dari mana memulai di tiap stack
Setiap ekosistem yang relevan punya satu yang sudah matang, dan semuanya hanya berjarak satu command dari project yang sudah punya test. Ini yang saya pakai per stack.
| Stack | Tool | Mulai dari sini |
|---|---|---|
| JavaScript dan TypeScript | StrykerJS | npx stryker run, dibatasi lewat array mutate di stryker.config.json |
| Java dan JVM | PIT, disebut juga pitest | mvn test-compile org.pitest:pitest-maven:mutationCoverage |
| Python | mutmut, atau cosmic-ray | mutmut run, lalu mutmut browse untuk menyusuri survivor-nya |
| C# dan Scala | Stryker.NET dan Stryker4s | Keduanya memakai mutator set StrykerJS, jadi bentuk di atas berlaku tanpa perubahan |
Tidak satu pun dari tool ini menuntut test framework baru. StrykerJS menjalankan run Vitest atau Jest yang sudah Anda punya, PIT menjalankan run JUnit Anda, dan mutmut menjalankan run pytest Anda. Mencobanya pada satu modul hanya menghabiskan satu command dan satu penantian, bukan migrasi, dan karena itu layak dilakukan sebelum berdebat soal mengadopsinya.
Bacalah report-nya dari bawah, bukan dari atas. Score-nya adalah ringkasan yang akan Anda lupakan; daftar survivor adalah kumpulan pernyataan, masing-masing berkata bahwa baris tertentu ini bisa dirusak dan suite Anda akan tetap merilisnya. Di modul approval itu, yang survived hanya dua operator perbandingan dan tidak ada yang lain, dan itu memberi tahu saya persis ke mana keempat puluh satu test tadi memandang.
Biaya jujurnya, dan di mana sebaiknya dibelanjakan
Mutation testing itu lambat, dan berpura-pura sebaliknya adalah cara sebuah tim mencobanya sekali lalu meninggalkannya. Kerjanya berlipat: setiap mutant berarti satu run lagi dari test yang menyentuhnya. Besarnya masalah itu bisa dibaca dari tool-nya sendiri. Halaman depan PIT menjual kecepatan, mengklaim bisa menganalisis dalam hitungan menit apa yang dulu memakan waktu berhari-hari. mutmut mengiklankan bahwa ia mengingat pekerjaan yang sudah selesai supaya Anda bisa bekerja incremental, dan tahu test mana yang perlu dijalankan. StrykerJS punya incremental mode yang menyimpan hasil ke sebuah file untuk mempercepat run berikutnya. Anggap ketiganya sebagai bukti biayanya, bukan bukti ketiadaannya. Urutan yang saya pakai:
- Pilih modul yang jawaban salahnya berbiaya uang atau kepercayaan. Pricing, pajak, approval threshold, permission, apa pun yang menghitung nominal. Bukan seluruh repository, dan bukan UI.
- Batasi run-nya tepat ke path itu saja lalu biarkan selesai sekali. PIT menerima glob targetClasses dan targetTests, mutmut menerima source_paths, StrykerJS menerima array mutate. Sekarang Anda tahu biaya wall-clock sebenarnya sebelum ada yang menjadwalkannya.
- Baca survivor-nya lalu perbaiki test-nya, bukan score-nya. Survivor yang Anda putuskan untuk diterima sebaiknya diterima secara tertulis, dengan alasannya, di tempat yang sama dengan dokumentasi test Anda yang lain.
- Baru setelah itu pasang ke CI, dan jalankan nightly ketimbang per-commit kecuali Anda sudah mengukur bahwa durasinya masuk ke dalam penantian yang benar-benar ditoleransi tim Anda.
Itu risk trade yang saya ambil dengan mata terbuka. Modul yang tidak saya mutasi adalah modul di mana saya menerima coverage sebagai satu-satunya sinyal, dan bersikap eksplisit soal daftar modul itu lebih berharga daripada satu angka tingkat repository yang tidak dipercaya siapa pun. Cara itu juga menjaga run-nya tetap di dalam budget waktu yang menentukan apakah praktik ini masih hidup kuartal depan.
Prompt dari spesifikasi, bukan dari implementasi
Semua di atas adalah deteksi. Akarnya ada di satu baris prompt. Kalau satu-satunya artefak yang Anda berikan ke agent adalah file-nya, file itulah satu-satunya tempat nilai yang diharapkan bisa berasal. Berikan requirement-nya dan tahan implementasinya, maka test yang dihasilkan punya tempat lain untuk diturunkan. Dilabeli sebagai before dan after, perbedaannya lebih kecil dari yang terlihat:
# BEFORE — reliably produces tests that restate the code
Read src/approval/level.ts and write unit tests for it.
Get statement coverage on that file above 90 percent.

# AFTER — produces tests that can fail
Do not open src/approval/level.ts.

Here is the requirement:
  level 1 up to and including 10,000,000
  level 2 above 10,000,000 up to and including 50,000,000
  level 3 above 50,000,000
  a negative amount is rejected, not routed

Write the tests from this requirement alone.
Include the exact boundary for every rule: 10,000,000 and 50,000,000 must
each appear as their own case, with the level the requirement gives them.

Then, before you finish: write out two plausible wrong implementations of
this rule — one that uses strict comparison at both boundaries, one that
checks the branches in the opposite order — and confirm that at least one
of your tests fails against each. Report any test that passes against both.
Instruksi terakhir itu mengubah output lebih banyak dari instruksi lainnya, dan itu adalah pendekatan murah dari apa yang dilakukan mutation testing secara benar. Suruh agent menuliskan implementasi yang salah lalu memeriksa test buatannya sendiri terhadap implementasi itu. Test yang lulus terhadap versi yang benar dan yang salah sekaligus adalah mutant survived, ditemukan sebelum kodenya ada dan bukan di report nightly. Kalau tidak ada spesifikasi tertulis, saya menuliskan aturannya dulu ke dalam prompt sebagai tiga atau empat baris prosa, dan kira-kira separuh waktu, latihan itulah yang memunculkan ambiguitas yang sebenarnya.
Kalau tidak ada spesifikasi yang bisa dipegang, jangan kembali ke file-nya. Minta agent menyatakan dalam prosa aturan apa yang menurutnya diimplementasikan kode itu, lalu bandingkan pernyataan itu dengan pemahaman Anda sendiri. Kalau Anda tidak setuju, Anda sudah menemukan bug sebelum menulis satu test pun. Kalau Anda setuju, sekarang Anda punya spesifikasi yang tadi hilang dan test bisa ditulis dari sana.
Coverage bukan kebohongan. Ia jawaban yang akurat untuk pertanyaan yang diam-diam berhenti berguna. Ketika menulis kode masih mahal, menjalankan setiap baris adalah proksi yang wajar untuk seseorang sudah memikirkan setiap baris, dan agent mematahkan proksi itu dengan mengeksekusi semuanya sementara tidak ada yang memikirkan apa pun. Aturan yang sekarang saya pegang pendek saja: sebuah test hanya layak atas waktu run-nya kalau ia akan gagal terhadap implementasi salah yang masuk akal. Beri agent requirement-nya, dan biarkan mutant yang survived memberi tahu Anda apakah ia menurut.
Sumber dan bacaan lanjutan
- Dokumentasi Stryker — mutant states dan metrics: killed, survived, no coverage, dan formula mutation score
- Dokumentasi Stryker — daftar mutator yang didukung, dengan bentuk asli dan bentuk termutasi tiap operator
- StrykerJS — referensi konfigurasi untuk mutate, testRunner, reporters dan incremental
- PIT — Maven quick start, goal mutationCoverage, targetClasses dan withHistory
- mutmut — mutation testing untuk Python: mutmut run, mutmut browse dan source_paths