
Ringkasan Utama
Agen yang memulai setiap run dari nol akan mengulang kesalahan yang sama selamanya. Tiga berkas memperbaikinya: pengetahuan yang dikurasi, pelajaran yang terakumulasi, dan handoff antar sesi — semuanya diindeks untuk pencarian semantik, dengan langkah refleksi di akhir tiap run yang menambahkan satu pelajaran baru lalu mengindeksnya ulang.
Beberapa minggu pertama, agen coding harian saya tidak punya memori. Setiap run dimulai dengan repositori dan instruksinya, bekerja setengah jam, membuka pull request, lalu melupakan semuanya. Ia kompeten dan sekaligus seperti film Groundhog Day: salah paham yang sama soal sebuah fixture, asumsi keliru yang sama soal sebuah helper, tiga kali dalam satu minggu.
Perbaikannya ternyata kecil — tiga berkas markdown, sekitar seratus lima puluh baris Python, dan satu instruksi di akhir run. Beginilah semuanya menyatu, dan bagian mana yang benar-benar membuktikan kegunaannya.
Tiga berkas, tiga tugas berbeda
Godaannya adalah satu berkas catatan besar. Itu gagal karena ketiga jenis memori punya siklus hidup berbeda: satu dikurasi manusia, satu terakumulasi otomatis, dan satu ditimpa terus-menerus.
| Berkas | Siapa yang menulisnya | Apa isinya |
|---|---|---|
| Knowledge | Saya, secara sengaja, sesekali | Pola dan standar domain: bagaimana transisi status seharusnya dimodelkan, apa arti operasi idempoten di sini, fitur bahasa modern yang diutamakan |
| Lessons | Agennya, satu baris per run | Temuan spesifik bertanggal: helper ini mengembalikan undefined untuk path yang tidak ada, build kehabisan memori di mesin ini |
| Sessions | Agennya, di akhir setiap run | Handoff singkat: hari ini saya mengerjakan apa, berikutnya kerjakan apa — dibaca di awal run berikutnya demi kesinambungan |
Memisahkannya juga penting secara operasional. Knowledge di-commit dan ditinjau; lessons dan sessions cukup diseed sekali lalu hanya ditambahi, sehingga penimpaan yang tidak sengaja tidak menghapus detail berminggu-minggu.
Pencarian vektor tanpa basis data vektor
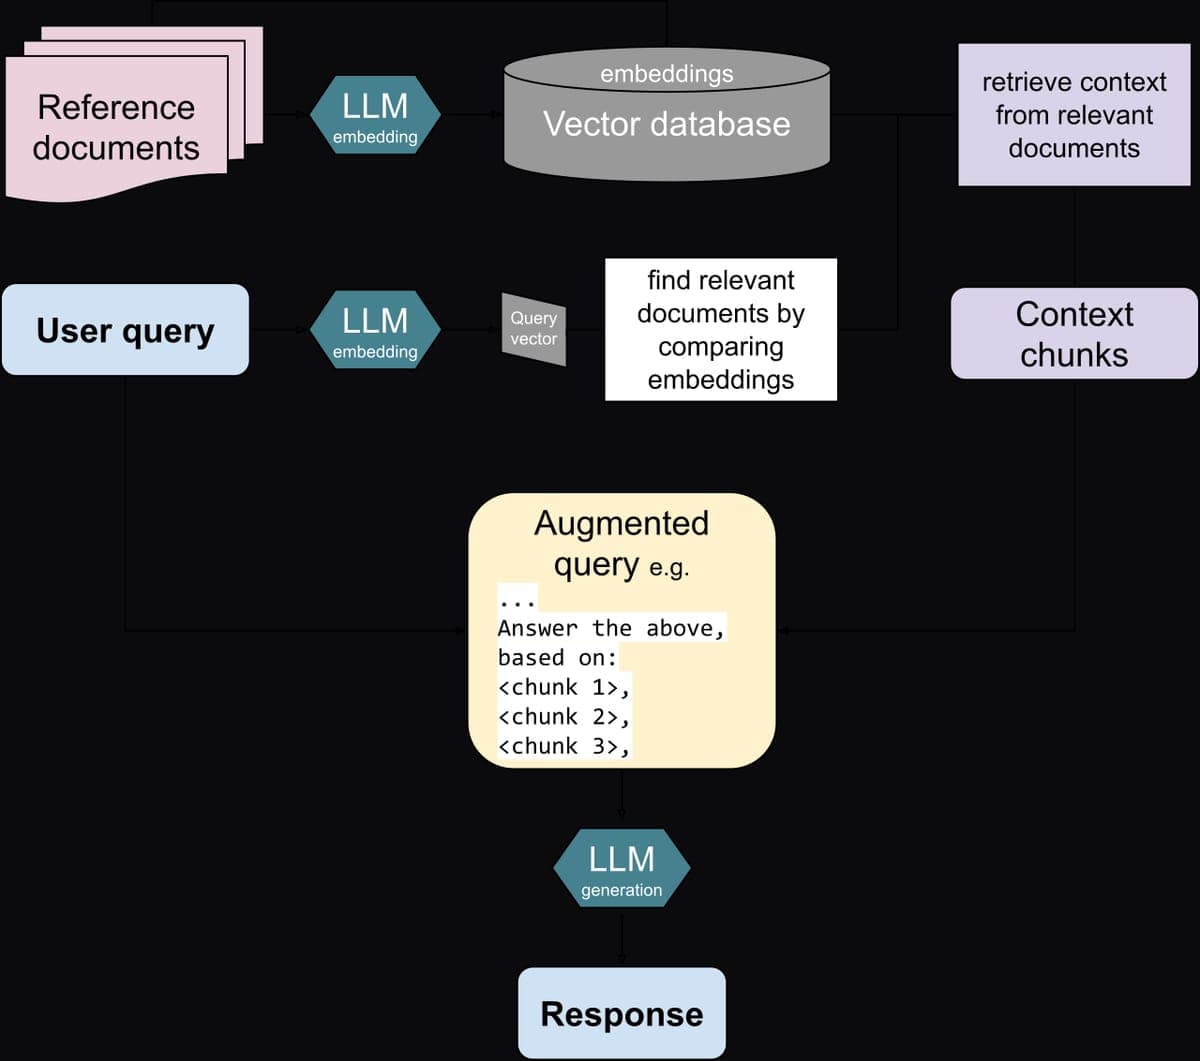
Begitu ada tiga berkas yang terus bertumbuh, menumpahkan semuanya ke prompt berhenti masuk akal, dan grep terlalu literal untuk menemukan catatan yang penting. Jalan tengahnya adalah skrip pengambilan kecil: potong markdown-nya per heading, embed tiap potongan, lalu urutkan dengan cosine similarity.
# kb.py — stdlib-only vector search over the agent's own notes.
# No vector database, no framework, about 150 lines.
#
#   kb index KNOWLEDGE.md LEARNINGS.md SESSIONS.md
#   kb search "how do we handle idempotency" 5

def chunk(markdown: str) -> list[str]:
    """Split on level-2 headings, then sub-split anything over ~1200 chars."""

def embed(texts: list[str]) -> list[list[float]]:
    """One HTTP call per chunk to a free embedding endpoint.
    On any failure, fall back to lexical token overlap so a run never
    breaks because an embedding API was down."""

def search(query: str, k: int) -> list[tuple[float, str]]:
    """Cosine similarity against the on-disk index, top k returned."""

# Index resolution walks UP from the working directory, the way git
# finds .git, so a search works from any subdirectory of the repo.
Dua keputusan membuat ini praktis. Pertama, fallback leksikal: kalau panggilan embedding gagal karena alasan apa pun, skripnya jatuh ke tumpang-tindih token sehingga sebuah run tidak pernah rusak karena API sedang mati. Kedua, resolusi indeks yang berjalan naik dari direktori kerja sebagaimana git menemukan root-nya sendiri, sehingga pencarian bekerja dari mana pun di dalam repositori.
Periksa interpreter mana yang sungguh ada di dalam container agen Anda sebelum menulis skripnya. Milik saya tidak punya Python sistem sama sekali — hanya virtual environment milik runtime — jadi perkakasnya berupa wrapper dua baris yang meng-exec interpreter itu. Menemukan ini setelah menulis skripnya memakan satu jam.
Lingkar yang membuat pengetahuan berbunga
Pengambilan saja hanyalah tabel pencarian. Yang mengubahnya menjadi pembelajaran adalah pipeline per item ditambah langkah refleksi, dan langkah refleksi itulah yang paling sering ditinggalkan kebanyakan setup.
# The per-item loop, written into the agent's persistent instructions.
# Each step costs turns, which is exactly why the budget must be stated.

1. RETRIEVE   kb search "<the item you are about to do>"
2. EDGE CASES consider empty, null, zero, negative, boundary, duplicate,
              already-terminal — pick the ones that apply
3. EDIT       the smallest change that covers them
4. SELF-REVIEW re-read your own diff as a reviewer would. If it is
              trivial or wrong, rewrite it before committing
5. COMMIT     one logical change, conventional commit message

# At the END of the run:
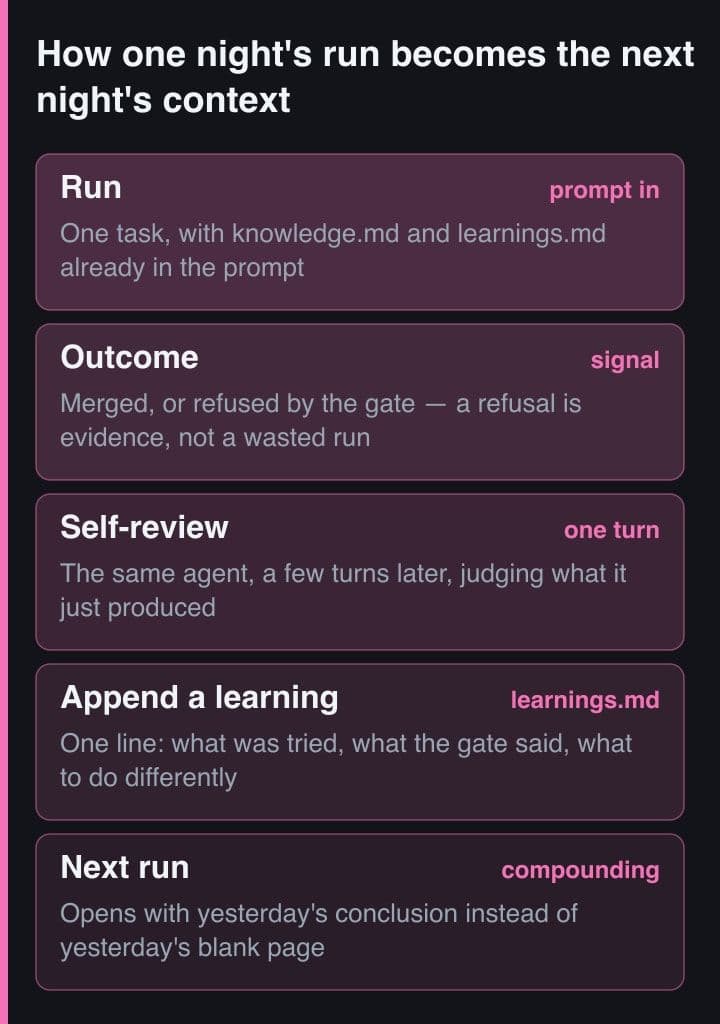
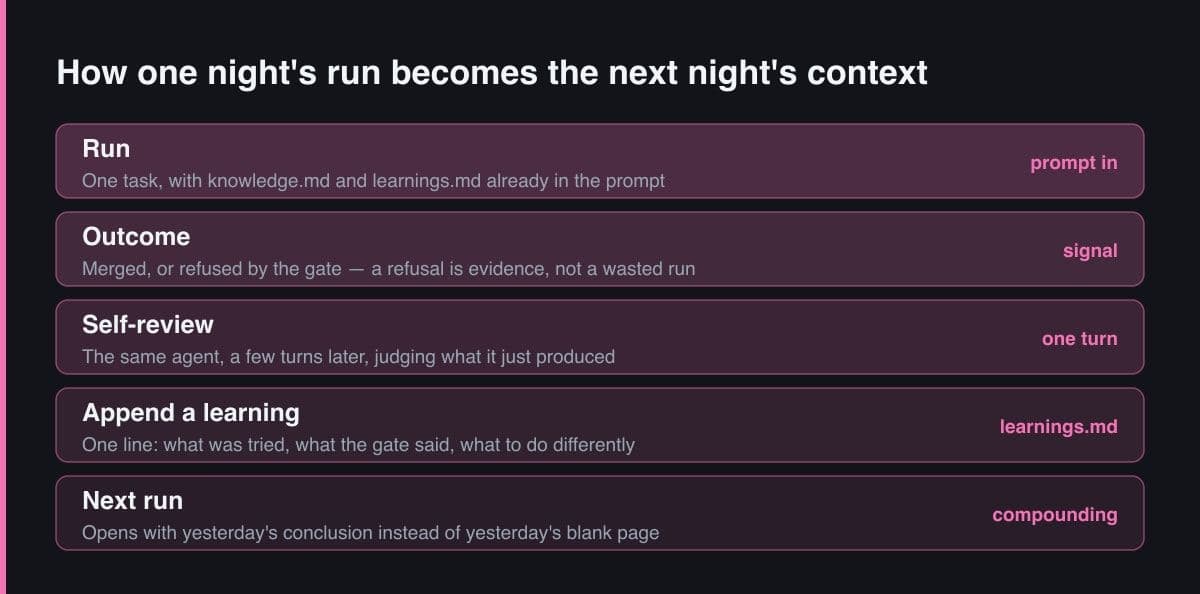
6. REFLECT    append one dated lesson to LEARNINGS.md
7. REINDEX    kb index — so the next run can retrieve today's lesson
Urutan pipeline-nya sengaja. Ambil dulu, agar edge case yang dipertimbangkan agen diinformasikan oleh temuan run sebelumnya. Tinjau sendiri sebelum commit, karena model yang membaca diff-nya sendiri sebagai peninjau menangkap tes yang jelas-jelas salah yang baru saja ia tulis. Lalu refleksi dan indeks ulang, agar pelajaran hari ini bisa diambil besok. Langkah terakhir itulah yang menutup lingkarnya; tanpanya berkas lessons bertumbuh dan tak ada yang pernah membacanya.
Pipeline pengambilan yang lebih kaya memakan giliran, dan anggaran pendaratan harus tumbuh mengikutinya. Run pertama di bawah lingkar ini menghasilkan sebelas commit bagus dan tidak pernah membuka pull request-nya, karena pengambilan ditambah analisis edge case ditambah tinjauan diri memakan sekitar tujuh giliran per item dan menghabiskan seluruh anggaran. Menurunkan target commit memperbaikinya.
Apa yang sesungguhnya masuk ke berkas knowledge
Isi yang benar-benar mengubah perilaku lebih spesifik daripada dugaan saya, dan lebih soal standar ketimbang soal fakta.
- Invarian domain. Status dan transisi yang eksplisit, fungsi guard yang murni, efek samping di tepian, kelengkapan audit — aturan yang akan diterapkan peninjau tanpa berpikir.
- Satu bagian anti-pola. Tes yang selalu benar secara sepele, terlalu banyak mock, membungkam tipe alih-alih memperbaikinya, memperbaiki bug yang sama dua kali. Menyebut nama anti-polanya lebih efektif daripada menggambarkan idealnya.
- Idiom bahasa modern yang diutamakan, lengkap dengan namanya. Nama fitur yang konkret bisa diambil kembali; tulis kode modern yang bagus tidak bisa.
- Keanehan repositori yang tidak bisa ditemukan dalam satu run: perintah mana yang kehabisan memori, helper mana yang nilai kembaliannya mengejutkan, tes mana yang butuh layanan sungguhan.
Kategori terakhir adalah yang paling baik disumbang agennya. Ia tidak bisa memberi tahu Anda apa itu desain yang baik, tetapi ia sangat baik dalam mencatat bahwa sebuah helper mengembalikan undefined ketika diberi path tanpa titik, pada hari ketika hal itu memakan dua puluh menit waktunya.
Apakah ini benar-benar membantu?
Bukti jujurnya tidak langsung tetapi konsisten. Kueri semantik memberi skor tertinggi tepat pada potongan yang akan dipilih manusia, berkas lessons bertumbuh dari satu baris menjadi lebih dari dua puluh dalam beberapa hari setelah langkah refleksi ditambahkan, dan salah paham spesifik yang dulu berulang berhenti berulang.
Yang tidak ia lakukan adalah membuat model lemah menjadi kuat. Pengambilan mencegah kesalahan berulang; ia tidak menambah kapabilitas. Kenaikan throughput di proyek saya datang dari prosedur — ukuran tugas, anggaran giliran, tenggat pendaratan — dan memorilah yang mencegah kenaikan itu tergerus tiga kesalahan yang sama setiap minggu.
Membangun ini dalam satu sore
Lima langkah, dalam urutan ini, dan berhenti setelah langkah ketiga kalau itu sudah cukup bagi Anda.
- Buat berkas lessons dengan langkah seed-jika-tidak-ada, agar ia tidak mungkin tertimpa oleh penggelaran ulang, lalu tambahkan satu instruksi: tambahkan pelajaran bertanggal di akhir setiap run.
- Minta agen membaca beberapa pelajaran terakhir di awal run. Ini saja sudah menghapus sebagian besar kesalahan berulang dan tidak berbiaya apa pun.
- Tulis sendiri berkas knowledge-nya, sekali, berisi standar dan anti-pola yang akan Anda tegakkan saat meninjau.
- Tambahkan pengambilan hanya ketika berkasnya sudah cukup besar sehingga membacanya utuh menjadi pemborosan — dan tambahkan fallback leksikalnya sekaligus.
- Indeks ulang setelah langkah refleksi, lalu verifikasi dengan mencari frasa dari pelajaran hari ini dan memastikan ia kembali.
Langkah kelima adalah verifikasi yang paling sering dilewati orang, dan hanya itulah yang membuktikan lingkarnya benar-benar tertutup alih-alih sekadar terkonfigurasi.
Memori mengubah agen dari orang asing yang kompeten menjadi rekan kerja yang kemarin ada di sini. Tiga berkas dengan siklus hidup berbeda, seratus lima puluh baris pengambilan, dan satu instruksi refleksi sudah cukup — dan disiplin yang membuatnya bekerja bukan pencarian vektornya, melainkan ingatan untuk mengindeks ulang agar pelajaran hari ini bisa ditemukan besok.