

Ringkasan Utama
Prompt regression testing berarti menjalankan sekumpulan kegagalan production nyata terhadap versi model yang sudah di-pin setiap kali prompt berubah. Assert secara deterministik dulu — JSON valid, field wajib, refusal — dan sampel setiap case beberapa kali, karena panggilan yang identik tidak mengembalikan teks yang identik. Pakai LLM judge hanya setelah Anda mengkalibrasinya terhadap label Anda sendiri.
Perubahannya hanya satu kalimat. Sebuah extractor invoice supplier punya system prompt yang paragraf terakhirnya mengatur format output, dan saya memindahkan satu baris tentang keringkasan ke bagian atas, karena jawabannya bertele-tele. Semua dokumen yang saya coba manual kembali sebagai JSON yang bersih. Empat hari kemudian sebuah batch job mati pada satu invoice hasil scan, dan penyebabnya adalah model mulai menulis satu kalimat sopan sebelum JSON pada input yang dianggapnya tidak biasa.
Tidak ada satu pun di pull request itu yang bisa direview. Prompt adalah kode tanpa type system dan tanpa compiler, jadi satu-satunya yang berdiri di antara instruksi yang diubah kata-katanya dan produk yang ikut berubah adalah suite yang menjalankan prompt itu lalu memeriksa hasilnya. Tulisan ini tentang cara saya membangun suite tersebut dan, yang lebih penting, cara menjaganya tetap jujur: dari mana case-nya berasal, kenapa assertion yang murah mengerjakan sebagian besar pekerjaan, bagaimana mengkalibrasi judge sebelum mempercayainya, dan apa yang harus dilakukan di pagi hari saat suite itu merah.
Setiap fixture adalah bug yang memang pernah terjadi
Mulailah kumpulan fixture dari antrean insiden, bukan dari papan tulis. Case yang Anda karang menguji perilaku yang sudah Anda yakini benar. Case yang diangkat dari support ticket menguji perilaku yang pernah gagal sekali, di depan pengguna sungguhan, dan itulah satu-satunya bukti keras bahwa prompt ini memang bisa gagal. Itu juga yang mencegah suite berubah menjadi museum hal-hal yang tidak pernah berisiko, sekaligus membuat suite bertambah karena ada alasannya, bukan karena jadwal.
# evals/cases/invoice-extract/0042-amount-suffix.yaml
#
# Provenance: SUP-2411, reported 2026-02-03, closed 2026-02-05.
# A supplier sent an invoice with the total written "Rp 12.500.000,-".
# The extractor got the number right and then wrapped the JSON in a polite
# sentence, so the downstream parser threw. Both halves of that are the case.
#
# Do NOT tidy the fixture. The trailing dash after the amount and the line
# break inside the supplier name are the reason this file exists; normalising
# them turns a regression test into a formatting test.
vars:
  document: file://fixtures/SUP-2411.txt

assert:
  # The complaint, expressed literally: JSON, and nothing around it.
  - type: is-json
    value: file://schemas/invoice.schema.json

  # The number the reporter actually cared about. Not "roughly right".
  - type: javascript
    value: JSON.parse(output).total_idr === 12500000

  # The regression we shipped WHILE fixing this the first time.
  - type: not-contains
    value: "Here is"
Dua kebiasaan menjaga case itu tetap berharga. Salin input yang bermasalah apa adanya: pemisah ribuan yang nyasar, tanda hubung di belakang nominal, pergantian baris di tengah nama supplier adalah seluruh alasan case itu ada, dan merapikannya sama saja dengan diam-diam menghapus test-nya. Lalu tulis assertion sebagai keluhan pelapor, bukan sebagai gambaran Anda tentang jawaban yang baik. Pelapor bilang parser-nya error, jadi assertion-nya adalah output harus bisa di-parse. Pelapor bilang totalnya salah, jadi assertion-nya menyebut angka total itu persis. Komentar provenance yang mencantumkan nomor ticket dan tanggalnya adalah yang membuat engineer berikutnya bisa memutuskan apakah case itu masih relevan.
Assertion deterministik dulu, dan biasanya hanya itu
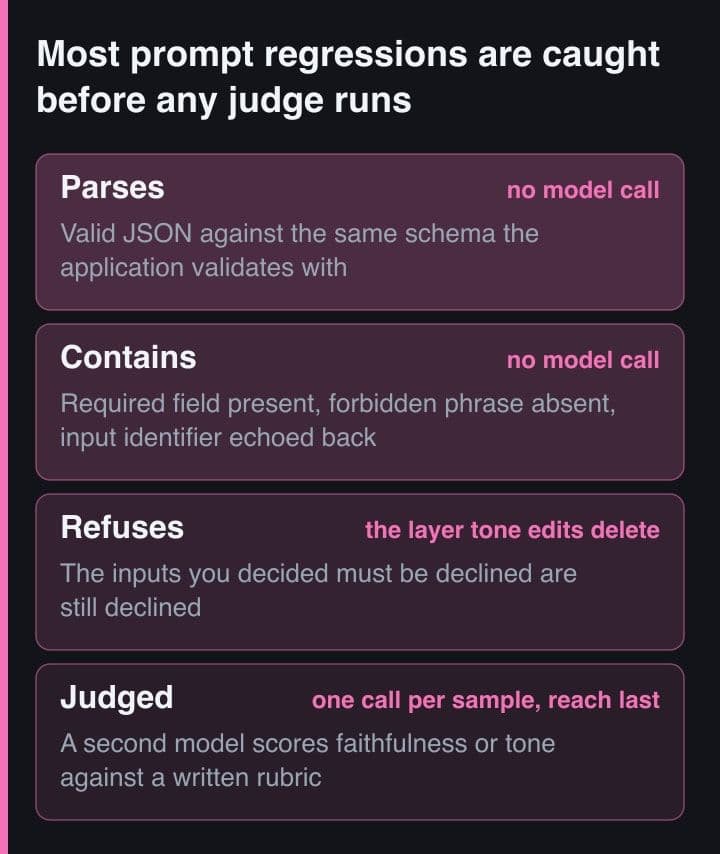
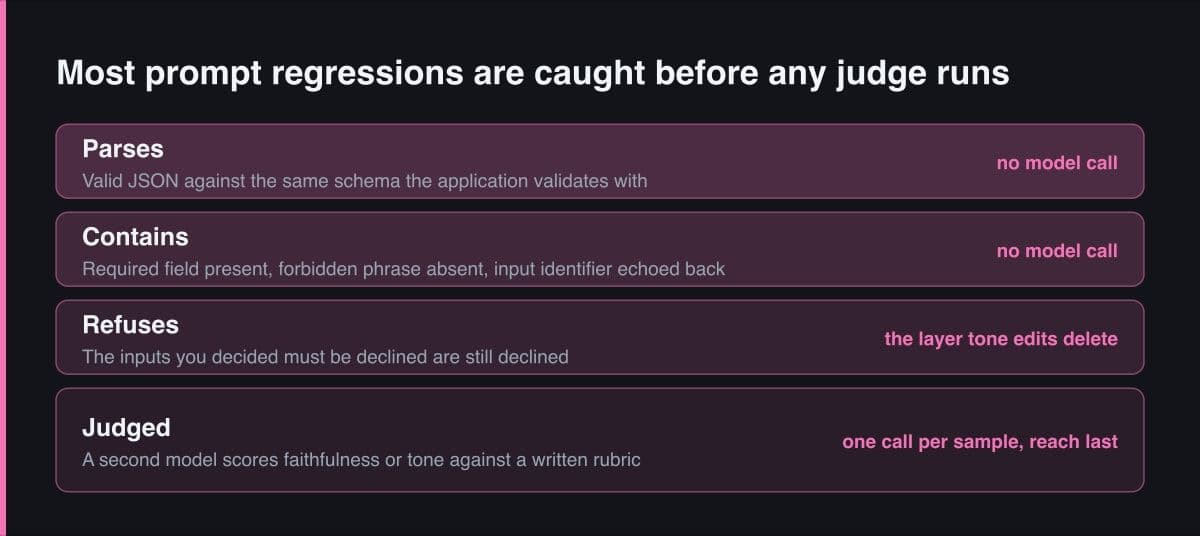
Sebagian besar regresi prompt adalah regresi bentuk, dan bentuk bisa diperiksa tanpa model kedua. Sebelum judge mana pun ikut campur, empat pertanyaan berikut sudah menutup mayoritas hal yang benar-benar rusak, dan keempatnya kode biasa:
- Bisa di-parse? JSON valid terhadap response schema, diperiksa dengan validator yang sama dengan yang dipakai aplikasi, bukan versi longgar yang khusus ditulis untuk test.
- Berisi yang wajib ada? Field yang diwajibkan hadir, frasa terlarang tidak muncul, dan identifier yang masuk ikut keluar lagi.
- Menolak saat memang harus menolak? Input yang Anda putuskan harus ditolak prompt tetap ditolak. Lapisan inilah yang diam-diam hilang ketika seseorang menulis ulang system prompt demi nada bahasa.
- Masih di dalam anggaran? Panjang output, latency dan cost per panggilan sama-sama punya batas, dan perubahan yang melipatgandakan panjang jawaban tetap sebuah regresi walau setiap katanya benar.
Panduan Anthropic sendiri tentang membangun evaluation menyampaikan pertukaran yang sama dari sisi sebaliknya: utamakan jumlah di atas kualitas, karena lebih banyak pertanyaan dengan automated grading yang sinyalnya sedikit lebih lemah tetap lebih baik daripada sedikit pertanyaan yang dinilai manual. Assertion yang murah adalah alasan sebuah suite bisa cukup besar untuk mewakili kenyataan. Suite dua puluh case yang di-judge adalah alat ukur yang lebih kecil daripada suite empat ratus case yang dinilai kode, secanggih apa pun cara penilaiannya.
promptfoo menyediakan semua ini sebagai assertion type bernama, bukan sesuatu yang harus Anda tulis sendiri: is-json dengan schema, contains-all, icontains-any, is-refusal, starts-with, word-count, latency dan cost, ditambah escape hatch javascript dan python, serta prefix not- yang membalik semuanya. YAML-nya titik awal yang masuk akal, bahkan kalau nantinya Anda menjalankan harness sendiri.
Prompt yang sama tidak mengembalikan output yang sama
Satu kali run hampir tidak membuktikan apa pun, dan alasannya layak diketahui persis. Thinking Machines Lab mengambil seribu sampel dari satu prompt pada temperature 0 terhadap Qwen3-235B dan mendapat delapan puluh completion yang unik, identik pada 102 token pertama lalu bercabang setelah itu. Penyebab yang mereka tunjuk bukan folklore floating-point yang biasa dipakai, melainkan ketiadaan batch invariance pada kernel inference: hasilnya bergantung pada batch tempat request Anda mendarat, dan batch itu bergantung pada seberapa sibuk server-nya, yang bukan urusan Anda untuk kendalikan.
// evals/run.ts
//
// Two tiers, because two kinds of rule share one suite:
//   contract  valid JSON, required field, refusal  -> every sample must pass
//   quality   tone, completeness, judged           -> one sample may miss
const SAMPLES = 5;

export async function runCase(c: EvalCase): Promise<CaseResult> {
  const outputs: string[] = [];
  for (let i = 0; i < SAMPLES; i++) {
    outputs.push(
      await callModel({
        // Imported from src/llm/model.ts. Never an alias, never "latest",
        // and never read from an environment variable that CI can drift.
        model: PINNED_MODEL,
        system: c.prompt,
        user: c.input,
      }),
    );
  }

  const passes = outputs.filter((o) => c.assertions.every((a) => a(o))).length;
  const required = c.tier === "contract" ? SAMPLES : SAMPLES - 1;

  return {
    id: c.id,
    // The result is the count. "Passed" is what you derive from it, and it is
    // the count, not the boolean, that a future red run gets read against.
    passes,
    samples: SAMPLES,
    required,
    ok: passes >= required,
    model: PINNED_MODEL,
  };
}
Jadi ambil sampel. Setiap case dijalankan beberapa kali dan hasilnya sebuah hitungan, bukan boolean. Saya memisahkan case menjadi dua tier, contract rule yang harus lolos di setiap sampel dan quality rule yang boleh meleset satu kali, karena suite dengan satu threshold tunggal akan memilih antara memaklumi JSON rusak atau gagal gara-gara sinonim. Menurunkan temperature juga bukan jalan keluar seperti yang terlihat: Anthropic kini men-deprecate temperature, top_p dan top_k pada Claude Opus 4.7 ke atas, di mana nilai non-default mengembalikan 400. Parameter yang biasa dipakai orang supaya eval bisa diulang justru sedang dipensiunkan.
Judge yang belum dikalibrasi adalah alat ukur tanpa skala
Ada hal yang memang butuh model kedua: kesetiaan pada dokumen sumber, apakah sebuah jawaban benar-benar menjawab, nada bahasa terhadap rubrik tertulis. Kesalahannya adalah menambahkan judge lalu langsung memercayai angkanya, karena pada titik itu Anda memasukkan alat ukur baru dan tidak pernah mencocokkannya dengan apa pun. Kalibrasi dengan cara yang membosankan. Beri label sendiri pada sekumpulan output, jalankan judge pada output yang sama, lalu hitung tingkat kesepakatannya.
// evals/calibrate-judge.ts
//
// Cohen's kappa between MY labels and the judge's, over the same outputs.
//
//   kappa = (po - pe) / (1 - pe)
//   po = agreement observed, pe = agreement expected by chance
//
// Why not plain percentage agreement: on a sample where 90 percent of
// outputs are good, a judge that answers "good" to everything scores
// 90 percent and has measured nothing at all. Kappa scores it 0.
type Label = "pass" | "fail";

export function cohensKappa(mine: Label[], judge: Label[]): number {
  const n = mine.length;
  const agreed = mine.filter((m, i) => m === judge[i]).length;
  const po = agreed / n;

  const rate = (xs: Label[], l: Label) => xs.filter((x) => x === l).length / n;
  const pe =
    rate(mine, "pass") * rate(judge, "pass") +
    rate(mine, "fail") * rate(judge, "fail");

  return (po - pe) / (1 - pe);
}

// Label the sample BEFORE you see the judge's answers, and re-run this
// whenever the rubric, the judge prompt or the judge model moves. A judge
// that has never been through it is an instrument with no scale on it.
Pakai Cohen's kappa, bukan persentase kesepakatan mentah. Kappa adalah kesepakatan yang teramati dikurangi kesepakatan yang diharapkan terjadi secara kebetulan, dibagi satu dikurangi kesepakatan kebetulan itu, dan itulah sebabnya judge yang menjawab pass untuk semuanya pada sampel yang sembilan puluh persen pass akan mendapat kesepakatan sembilan puluh persen dengan kappa nol. Pita Landis dan Koch dari 1977 adalah yang paling sering dikutip — 0.41 sampai 0.60 moderate, 0.61 sampai 0.80 substantial — dan Wikipedia benar mencatat bahwa pita itu berasal dari pendapat pribadi dan tidak ada satu nilai kappa pun yang bisa disebut berlaku umum. Tentukan batas Anda sendiri, tulis di repository berdampingan dengan rubriknya, dan ukur ulang setiap kali salah satunya berubah.
Judge juga sebuah prompt. Ia ikut hanyut bersama yang lain, jadi ia butuh model yang di-pin sendiri dan sekumpulan kecil regression case miliknya sendiri, termasuk output yang Anda tahu buruk dan memang harus dinilainya gagal. Menilai dengan model yang menghasilkan output itu adalah hal yang justru harus dihindari: independensi adalah properti yang Anda bayar, dan di situ Anda melepasnya cuma-cuma.
Pin model-nya, lalu jalankan suite saat Anda memindahkannya
Suite yang berjalan di atas model yang bergerak mengukur dua variabel sekaligus dan tidak bisa mengatribusikan keduanya. Pin identifier model yang persis di satu file, import dari situ ke mana-mana termasuk ke eval harness, dan perlakukan perubahan pada baris itu sebagai deploy yang butuh review sekelas perubahan prompt. Nilai dari pinning bukan karena model yang di-pin lebih baik. Nilainya adalah ketika suite jadi merah, Anda sudah tahu variabel mana yang bergerak.
| Yang berubah | Siapa yang memulai | Yang harus dilakukan suite |
|---|---|---|
| Kata-kata prompt | Anda, lewat pull request | Jalankan seluruh suite di branch, dengan prompt lama sebagai kontrol |
| Identifier model yang di-pin | Anda, dengan sengaja | Jalankan dua model pada case yang sama dan baca selisih per case sebelum merge |
| Model dipensiunkan penyedia | Penyedia, dengan pemberitahuan | Migrasi sebelum tanggalnya, dan biarkan suite memilih penggantinya |
| Retrieved context atau output tool | Tidak ada, diam-diam | Hanya run terjadwal pada prompt yang tidak berubah yang bisa melihat ini |
Pinning membeli kepastian niat, bukan keabadian. Halaman deprecation Anthropic menyatakan terus terang bahwa request ke model yang sudah retired akan gagal, dan halaman itu menerbitkan siklus hidupnya — active, legacy, deprecated, retired — dengan komitmen pemberitahuan minimal enam puluh hari sebelum sebuah model yang dirilis publik dipensiunkan. claude-3-7-sonnet-20250219 di-deprecate pada 28 Oktober 2025 dan retired pada 19 Februari 2026, dan aplikasi yang di-pin ke sana berhenti bekerja pada tanggal itu, bukan menurun perlahan. Suite adalah yang mengubah migrasi paksa itu menjadi perubahan terukur: jalankan pada tiap kandidat pengganti, baca selisih per case, lalu putuskan dengan bukti, bukan dengan release note.
Tier murah di setiap pull request, tier mahal tiap malam
Memisahkan suite berdasarkan biaya adalah yang membuatnya tetap berjalan sama sekali. Tier deterministik tidak menambah pengeluaran di luar panggilan generasi itu sendiri, jadi ia berjalan di setiap pull request yang menyentuh prompt, direktori eval, atau file berisi identifier model yang di-pin, dan exit code-nya memblokir merge. Tier yang di-judge memakan satu panggilan tambahan per sampel per case, jadi ia berjalan tiap malam dan sesuai permintaan, lalu menempelkan komentar alih-alih vonis.
# .github/workflows/prompt-evals.yml
name: prompt-evals

on:
  pull_request:
    paths:
      - "prompts/**"
      - "evals/**"
      # The pinned model ID lives here. Leave this line out and a model bump
      # merges without ever running the suite that exists to guard it.
      - "src/llm/model.ts"
  schedule:
    # Nightly, against an unchanged prompt. This run is the only thing that
    # sees drift nobody on the team initiated.
    - cron: "0 19 * * *"
  workflow_dispatch:

jobs:
  contract:
    # Deterministic assertions only. Fast, no judge, blocks the merge.
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: npm ci
      - run: npx tsx evals/run.ts --tier contract --samples 5
      - uses: actions/upload-artifact@v4
        if: always()
        with:
          name: eval-results-contract
          # Per case: model ID, sample count, pass count. A red run is only
          # diagnosable against the last green one.
          path: evals/out/results.json

  judged:
    # Costs a second model call per sample. Nightly and on demand only,
    # and it comments rather than blocking.
    if: github.event_name != 'pull_request'
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: npm ci
      - run: npx tsx evals/run.ts --tier quality --samples 5 --judge
Dua detail yang murah sekarang dan mahal nanti. Arahkan paths filter ke file identifier model, kalau tidak, kenaikan versi model akan ter-merge tanpa pernah menjalankan suite yang justru ada untuk menjaganya — ini lubang paling umum pada setup yang selebihnya sudah bagus. Lalu terbitkan hasil per case sebagai artifact yang membawa identifier model, jumlah sampel dan jumlah pass untuk setiap case, karena run yang merah baru bisa didiagnosis terhadap run hijau terakhir, dan kalimat suite-nya gagal bukanlah sebuah diff.
Catat jumlah sampel di artifact berdampingan dengan jumlah pass. Case yang hari ini empat dari lima dan minggu lalu juga empat dari lima itu stabil. Case yang sama membaca empat dari lima pada run yang hanya mengambil dua sampel adalah derau yang belum Anda ukur, dan hitungan itulah seluruh beda antara hasil dan anekdot.
Tiga arti dari suite yang merah
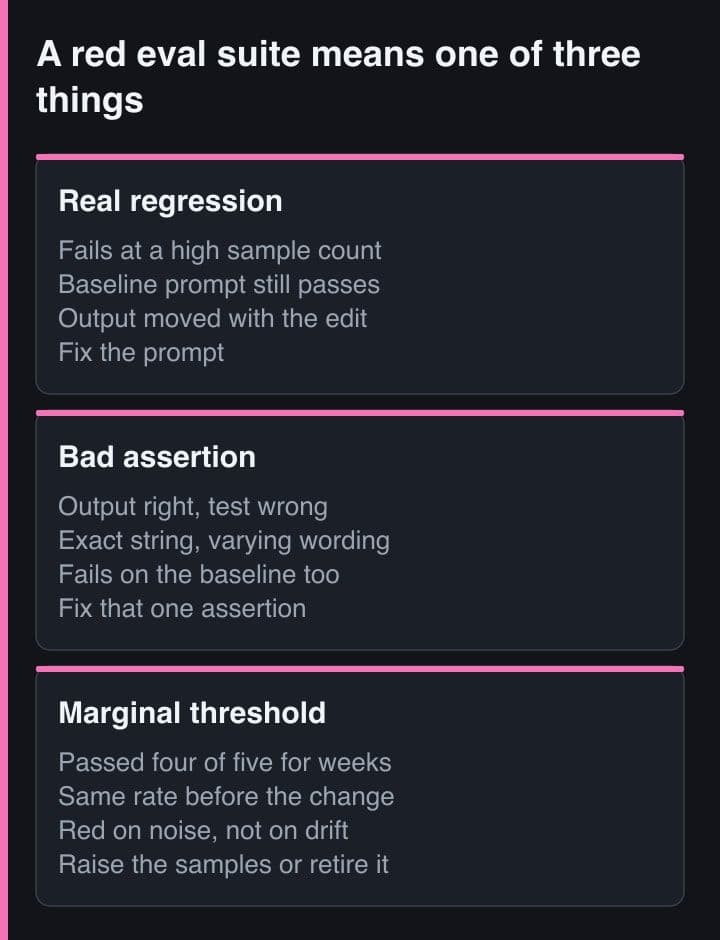
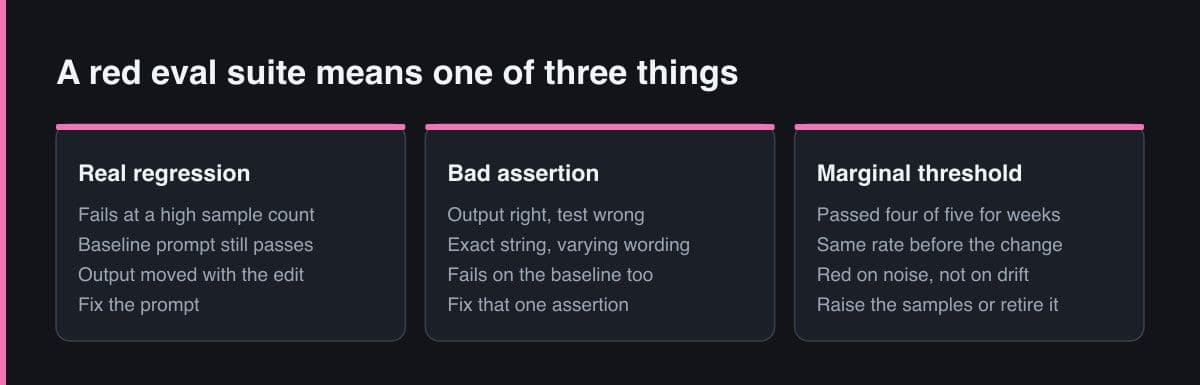
Merah adalah pertanyaan, bukan vonis, dan jawabannya cuma ada tiga. Kerjakan berurutan seperti ini, karena pemeriksaan termurah menggugurkan kesalahan yang paling sering terjadi:
- Jalankan ulang case yang gagal terhadap prompt yang tidak diubah, dengan jumlah sampel lebih besar. Kalau di sana ia juga gagal, masalahnya ada di case atau assertion-nya dan perubahan Anda tidak bersalah. Langkah inilah yang paling sering dilewati, dan melewatinya adalah cara sebuah prompt yang bagus berakhir di-revert.
- Baca output-nya, bukan selisih skornya. Assertion string persis terhadap kalimat yang sejak awal boleh bervariasi adalah assertion yang buruk, dan perbaikannya adalah melonggarkan satu assertion itu lalu mencatat alasannya di file case. Bukan menurunkan threshold seluruh suite.
- Periksa riwayat case-nya. Case yang sudah berminggu-minggu duduk di angka empat dari lima memang selalu marginal dan sekarang jatuh ke sisi lain garis. Naikkan jumlah sampelnya sampai rate-nya berarti, atau pensiunkan case itu, tapi jangan membukukan derau sebagai regresi.
Satu aturan lebih penting dari ketiganya: jangan pernah melonggarkan threshold di commit yang sama dengan perubahan prompt. Commit seperti itu tidak bisa direview, karena ia memuat perubahannya sekaligus izin untuk menerimanya, dan persis begitulah sebuah suite berhenti berarti apa-apa bagi orang yang membacanya. Melonggarkan adalah pull request-nya sendiri, dengan alasannya sendiri di pesan commit dan approval-nya sendiri.
Suite ini tidak ada untuk membuktikan prompt Anda bagus. Ia ada supaya perubahan pada prompt menghasilkan angka yang bisa diperdebatkan dua orang, bukan dua pendapat tentang nada bahasa. Bangun dari kegagalan yang memang sudah terjadi, assert dengan murah dan sering, ambil sampel cukup banyak sampai angkanya berarti, kalibrasi apa pun yang menilai, dan pin model-nya, supaya di pagi hari saat ia merah Anda sudah tahu apa yang bergerak.