

Ringkasan Utama
Harness AI agent adalah semua hal di sekitar model: instruksi, tools, context, file state, verifikasi, dan runner. Hasil yang dipublikasikan menunjukkan perubahan harness saja menaikkan satu model 13,7 poin di Terminal-Bench 2.0. Menjalankan agent Claude Code tanpa pengawasan mengajarkan hal yang sama kepada saya: sebagian besar kegagalan yang saya catat adalah bug harness, bukan kesalahan model.
Awal September, agent Claude Code saya yang berjalan tanpa pengawasan mulai melaporkan bahwa ia sudah menyentuh session cap langganan. Ia menulis cooldown marker, keluar dengan exit code 75, dan setiap job terjadwal lain di server melewatkan jadwalnya demi menunggu limit yang sebenarnya tidak ada. Detector yang saya tulis mencocokkan kata rate limit di mana saja dalam log run, padahal output stream-json Claude Code membawa objek rate_limit_info di setiap run, termasuk run yang sehat. Dua laporan session cap yang sempat saya sampaikan ternyata adalah bug itu.
Tidak ada yang salah dengan modelnya. Yang salah adalah harness di sekitarnya, dan ternyata itulah polanya. Tulisan ini menyandingkan pelajaran dari menjalankan agent tersebut dengan karya yang sudah dipublikasikan tentang harness engineering: tulisan engineering Anthropic, tim Codex OpenAI, eksperimen Terminal-Bench dari LangChain, studi context rot dari Chroma, Thoughtworks, dan tiga makalah riset. Ke-20 sumber diberi nomor dan tautan di bagian akhir, angka dalam kurung siku di teks merujuk ke sana, dan setiap angka yang berasal dari run saya sendiri ditandai sebagai milik saya.
Apa itu harness, dan apa yang bukan
Birgitta Böckeler dari Thoughtworks memberi definisi paling bersih: harness kini menjadi istilah singkat untuk segala sesuatu dalam AI agent selain modelnya sendiri, yang dirangkum sebagai Agent = Model + Harness. Gambaran referensi Anthropic tentang coding agent menunjukkan mengapa batas ini penting. Model hanyalah satu kolom pada diagram di bawah. Query, context yang dikirim ke model, pencarian file, loop menulis-dan-menguji, serta kondisi yang mengakhirinya adalah keputusan yang dibuat seseorang di luar model. [1, 2]
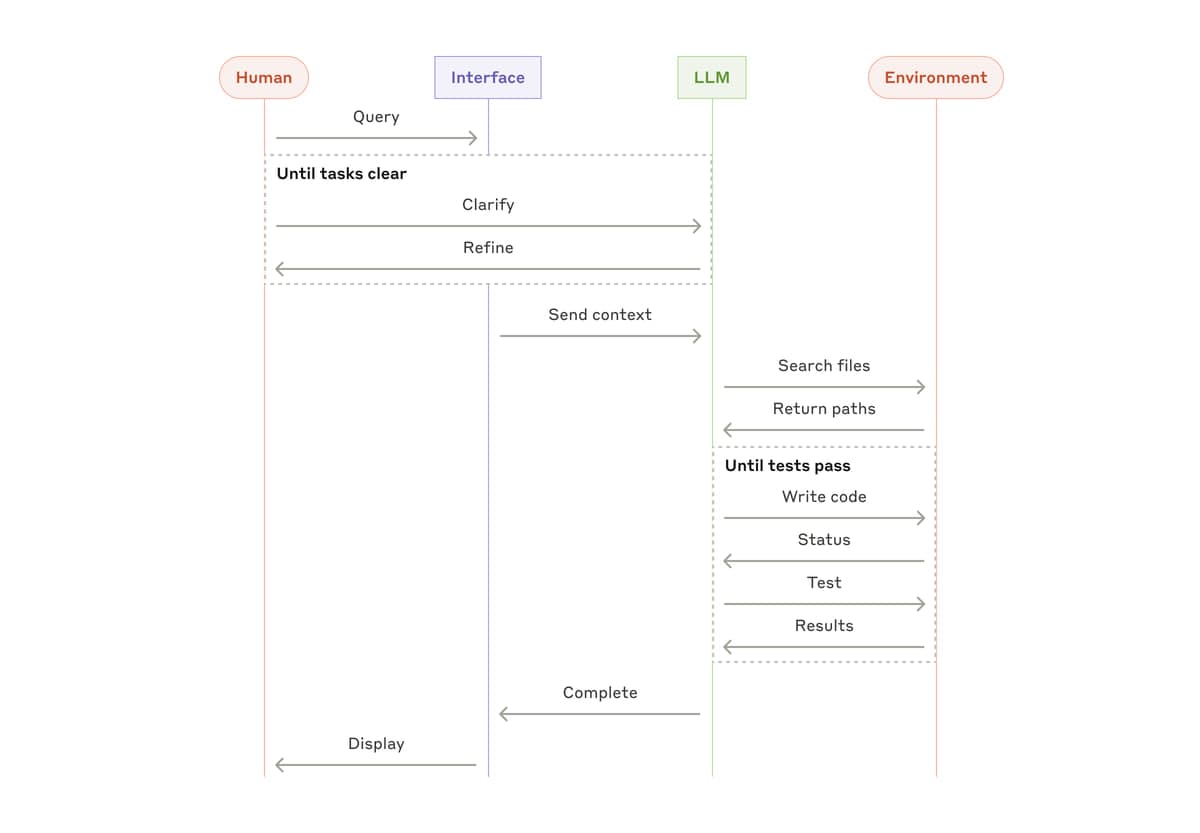
Böckeler membagi harness menjadi guide, yang mengarahkan agent sebelum bertindak, dan sensor, yang mengamati apa yang sudah dilakukan agar agent bisa mengoreksi diri. Keduanya bisa bersifat komputasional, seperti linter atau test run, atau inferensial, seperti reviewer berbasis LLM. Peringatannya adalah bagian yang paling berguna: feedback saja menghasilkan agent yang terus mengulang kesalahan yang sama, sedangkan feedforward saja menghasilkan agent yang menyimpan aturan tetapi tidak pernah tahu apakah aturan itu berhasil. Tim Codex OpenAI sampai di titik yang sama dari arah sebaliknya: menurut mereka, tantangan tersulit kini ada pada perancangan environment, feedback loop, dan sistem kontrol. [1, 3]
Jika dipetakan ke agent yang saya jalankan di VPS, lapisannya terlihat seperti ini. Tiga kolom pertama berlaku untuk harness apa pun; kolom terakhir adalah milik saya.
| Lapisan | Guide atau sensor | Apa yang ditentukannya | Di agent tanpa pengawasan saya |
|---|---|---|---|
| Instruksi | Guide | Apa yang diyakini agent sebagai pekerjaannya | Satu playbook per repository, tidak masuk git |
| Tools dan interface | Guide | Aksi mana yang murah dan mana yang mustahil | claude -p headless, prompt lewat stdin, model yang di-pin |
| Context | Guide | Apa yang ada di context window saat model memutuskan | Fakta yang dihitung runner, bukan pengulangan kebijakan |
| State antar-run | Guide dan sensor | Apa yang bertahan saat sesi berakhir | Knowledge, learnings, dan log sesi di luar git tree |
| Pemeriksaan deterministik | Sensor komputasional | Apakah pekerjaannya nyata | CI, ditambah gate jumlah test terhadap merge-base |
| Review | Sensor inferensial | Apakah pekerjaannya bagus | Invocation kedua yang hanya melihat diff |
| Runner | Plumbing | Apakah semuanya berjalan sama sekali | systemd timer, lock, dan exit code 75 untuk run yang terkena cap |
Model sama, harness berbeda, skor berbeda
Bukti paling bersih datang dari makalah SWE-agent, yang menahan GPT-4 Turbo tetap dan hanya mengubah agent-computer interface. Di SWE-bench Lite, interface lengkap menyelesaikan 18,0% issue, dan setiap penyederhanaan mengurangi poin, seperti terlihat di tabel. Anthropic melaporkan hal serupa saat membangun agent SWE-bench mereka: tim menghabiskan lebih banyak waktu mengoptimalkan tools daripada prompt secara keseluruhan, dan satu perubahan, yaitu mewajibkan path file absolut setelah model terus salah memakai path relatif, sudah cukup membuat model memakai path tanpa cela. [4, 2]
| Interface SWE-agent, GPT-4 Turbo tetap | Terselesaikan di SWE-bench Lite | Dibanding interface lengkap |
|---|---|---|
| Interface lengkap: file viewer 100 baris, pencarian yang diringkas, perintah edit dengan lint check | 18,0% | baseline |
| Perintah edit tanpa lint check | 15,0% | -3,0 poin |
| Viewer menampilkan seluruh file, bukan 100 baris | 12,7% | -5,3 poin |
| Pencarian iteratif, bukan hasil yang diringkas | 12,0% | -6,0 poin |
| Tanpa perintah edit sama sekali | 10,3% | -7,7 poin |
LangChain menjalankan eksperimen yang sama di benchmark terkini. Dengan gpt-5.2-codex tetap, mereka menaikkan deepagents-cli dari 52,8% menjadi 66,5% di Terminal-Bench 2.0, dari 30 besar ke 5 besar, hanya dengan mengubah harness. Trace mereka menunjukkan satu kegagalan yang lebih sering dari yang lain: agent menulis solusi, membaca ulang kodenya sendiri, menilai semuanya baik, lalu berhenti. Semua perbaikannya ada di harness. Sebuah middleware mencegat agent sebelum keluar dan memaksa satu putaran verifikasi terhadap spesifikasi tugas, middleware lain menghitung jumlah edit per file untuk menangkap doom loop, dan peringatan time budget mendorong agent memverifikasi sebelum waktunya habis. [5]
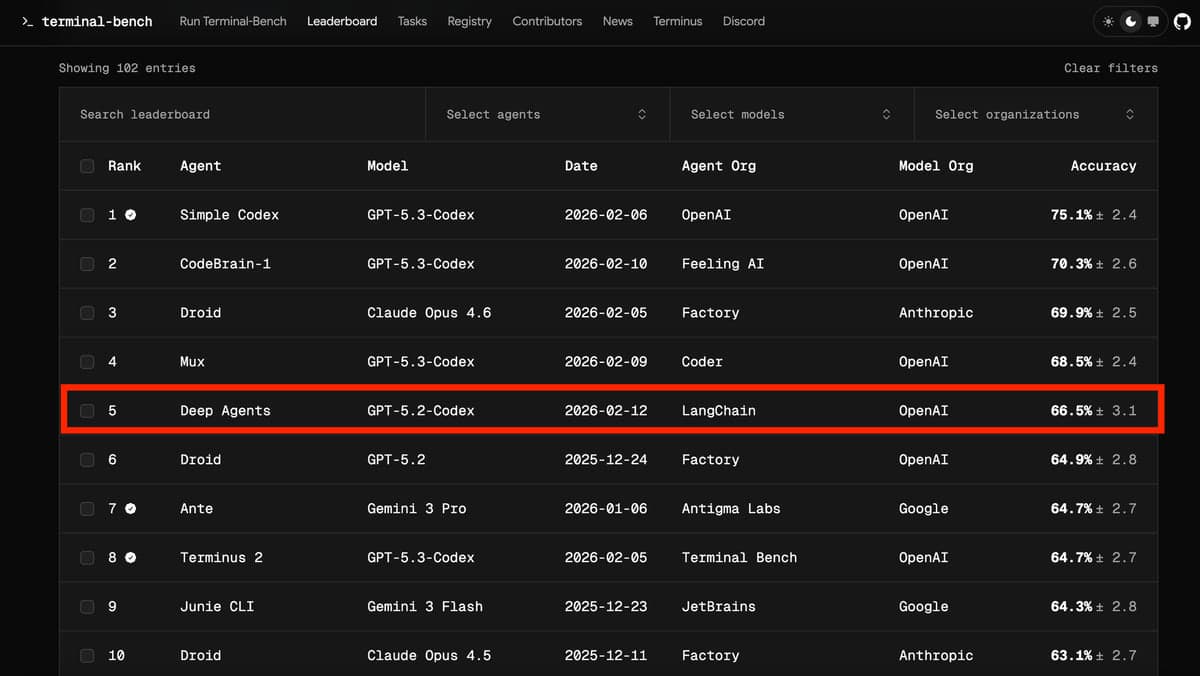
Selisih itulah inti yang jujur. Leaderboard mencantumkan error bar sekitar 2,4 sampai 3,1 poin, jadi jarak antara harness terbaik dan terburuk pada model yang sama beberapa kali lipat dari noise-nya. Leaderboard bukan eksperimen terkontrol: tim yang berbeda mengirim run tersebut pada tanggal yang berbeda, dan papan itu sudah berubah sejak cuplikan ini. Namun arahnya sama dengan ablasi SWE-agent dan run LangChain dengan model tetap, sehingga ada tiga jenis bukti yang sepakat. [6]
Sebelum mengganti model karena agent berkinerja buruk, ubah satu komponen harness lalu jalankan ulang set tugas yang sama. Dalam run LangChain, kegagalan yang paling sering diperbaiki oleh pemeriksaan yang aktif saat agent mencoba berhenti, bukan oleh model lain.
Context adalah anggaran, dan ia membusuk
Panduan context engineering dari Anthropic memperlakukan context sebagai sumber daya terbatas dengan diminishing marginal returns: setiap token memakai attention budget, dan transformer menghubungkan setiap token dengan semua token lain, n² pasangan untuk n token. Chroma mengukur harganya. Di 18 model, performa makin tidak andal seiring bertambahnya panjang input, bahkan pada tugas sederhana. Hasil paling tajam adalah perbandingan LongMemEval di bawah: pertanyaan yang sama, ditanyakan sekali hanya dengan sekitar 300 token yang relevan dan sekali dengan riwayat lengkap sekitar 113.000 token. [7, 8]
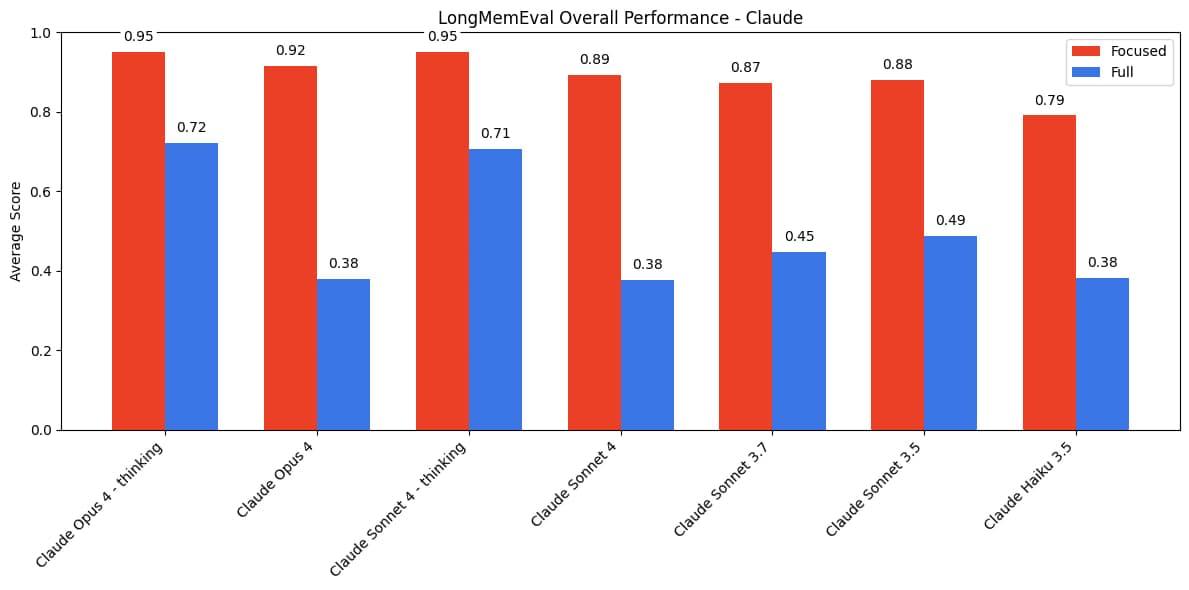
Posisi sama pentingnya dengan ukuran. Liu dan rekan menemukan akurasi tertinggi ketika bagian yang relevan berada di awal atau akhir input panjang, dan jauh lebih rendah ketika berada di tengah. Ada juga garis biaya yang langsung. Tim Manus menyebut KV-cache hit rate sebagai metrik terpenting untuk agent produksi, karena agent mereka membaca sekitar 100 token untuk setiap token yang ditulis, dan di Claude Sonnet input yang di-cache seharga 0,30 USD per juta token dibanding 3 USD tanpa cache. Harness yang menulis ulang awal prompt-nya setiap giliran membayar sepuluh kali lipat untuk kata-kata yang sama. [9, 10]
Bug context saya sendiri lebih senyap. Script runner dulu mengulang kebijakan playbook di dalam prompt, berjaga-jaga kalau agent melewatkannya. Kedua salinan itu bergeser. Prompt masih menggambarkan stranded branch sebagai branch tanpa pull request terbuka dan menyuruh agent merge dengan --rebase, sementara playbook di sebelahnya sudah pindah ke --auto dan aturan deteksi yang berbeda. Agent menerima dua perintah untuk satu situasi. Perbaikannya: runner hanya mengirim fakta yang tidak mungkin diketahui playbook.
# Wrong: the runner restates policy that also lives in the playbook.
# The copies drift, and the agent receives two sets of orders for one case.
prompt="There is a stranded branch with no open PR. Rebase it onto main,
then merge it with --rebase once CI is green."

# Right: the runner sends only facts the playbook cannot know.
# What to DO with them lives in one place: the playbook's Run order.
prompt=$(cat <<EOF
Facts computed by the runner for this pass (data, not instructions):
- stranded_branch: ${branch}
- commits_ahead_of_main: ${ahead}
- open_pr: ${pr_number:-none}
- coverage_targets (absolute uncovered branches, largest first):
${targets}
Follow the Run order in your playbook.
EOF
)

# Pass the prompt on stdin. --add-dir is variadic: a prompt placed after it
# is swallowed as a second directory and the run dies with "Input must be provided".
printf '%s' "$prompt" | claude -p --model claude-sonnet-5-5 --effort medium \
  --output-format stream-json --verbose | tee "$log.jsonl"
Aturan yang sama menentukan apa yang dihitung runner. Target coverage diurutkan berdasarkan jumlah absolut branch yang belum ter-cover, bukan persentase, karena file dengan coverage 85% dan 766 branch menyimpan lebih banyak pekerjaan daripada file 60% dengan lima branch. Sebelum urutan itu ada, agent menghabiskan giliran mencari target dan menyurvei ulang file yang sudah ditandai habis oleh catatannya sendiri.
Instruksi adalah peta, dan lokasi pemuatannya penting
Tim Codex OpenAI merilis produk sekitar satu juta baris dalam lima bulan tanpa kode yang ditulis manual, dan file instruksinya sengaja dibuat pendek: AGENTS.md sekitar 100 baris yang berfungsi sebagai daftar isi menuju folder docs yang terstruktur, sebuah peta alih-alih manual 1.000 halaman. Aturan yang harus selalu berlaku dipindahkan dari prosa ke custom linter dan structural test, karena begitu dikodekan, aturan itu berlaku di mana saja sekaligus. Anthropic menyebut target untuk prosa yang tersisa sebagai ketinggian yang tepat, di antara logika hard-coded yang rapuh dan panduan yang terlalu samar untuk dijalankan. [3, 7]
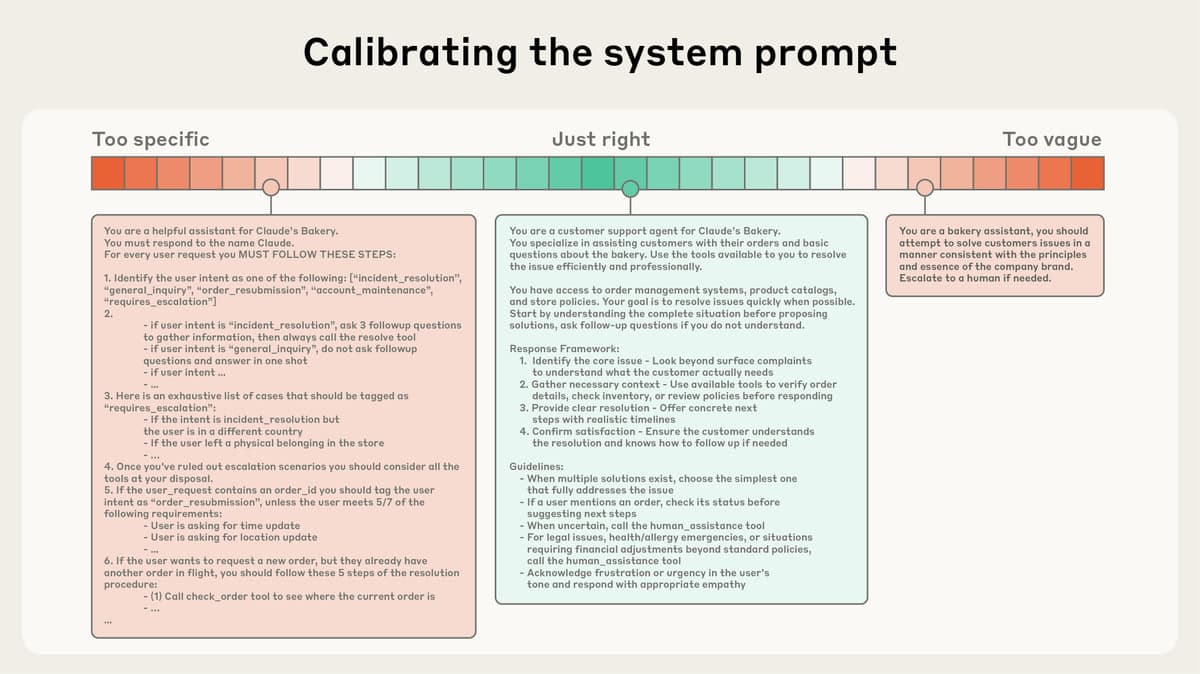
Lokasi file adalah bagian dari instruksi. Claude Code memuat CLAUDE.md dari working directory dan dari setiap direktori di atasnya, digabungkan alih-alih saling menimpa. Saya menaruh playbook agent di direktori induk clone repository supaya tidak mungkin ter-commit tanpa sengaja. Ternyata playbook itu juga dimuat untuk job kedua yang repository-nya berada di induk yang sama, dan saya baru bisa memastikannya setelah meminta sebuah run menyebutkan file yang dimuatnya. Perbaikannya: prinsip bersama tetap di atas, dan setiap playbook dipindah ke dalam clone-nya sendiri, disembunyikan dari git dengan local exclude. [11]
~/work/
├── CLAUDE.md               # shared principles: loads for EVERY job below it
├── KNOWLEDGE.md            # stable facts, pulled in by an @import
├── LEARNINGS.md            # appended after each run by the review step
├── SESSIONS.md             # what each run did, and what it left unfinished
├── hierarchical-approval/  # repository clone for the library job
│   ├── CLAUDE.md           # library playbook: imports @../KNOWLEDGE.md
│   └── .git/info/exclude   # lists CLAUDE.md, so it is never committed
└── devops-lab/
    └── CLAUDE.md           # lab playbook, scoped to the lab job only

# A local exclude, unlike .gitignore, is never committed, never shows as
# untracked, and survives "git clean -fd" (only -x removes it).
echo "CLAUDE.md" >> ~/work/hierarchical-approval/.git/info/exclude
Dua pelajaran kecil datang dari file yang sama. Import di-resolve relatif terhadap file yang memuatnya, bukan working directory, sehingga memindahkan playbook satu tingkat ke bawah mengubah @KNOWLEDGE.md menjadi @../KNOWLEDGE.md. Selain itu, menulis aturan tidak sama dengan menetapkan prioritas: dengan aturan stranded branch tertulis di prinsip dan update dependency disebut sebagai pekerjaan awal, agent memilih Dependabot sebagai aksi pertamanya. Bagian Run order yang bernomor memperbaikinya. [11]
Memori tinggal di file, bukan di context window
Harness long-running dari Anthropic berangkat dari dua kegagalan: agent yang mencoba mengerjakan terlalu banyak sekaligus lalu meninggalkan pekerjaan setengah jadi ketika context-nya habis, dan sesi berikutnya yang melihat ada kemajuan lalu menyatakan pekerjaan selesai. Perbaikannya berupa sekumpulan file. Sesi initializer menulis daftar fitur berisi lebih dari 200 item yang semuanya ditandai gagal, ditambah log kemajuan bernama claude-progress.txt, script init.sh, dan git commit pertama. Setiap sesi berikutnya membuat kemajuan bertahap dan meninggalkan catatan terstruktur. Daftar fitur sengaja berformat JSON, karena model lebih kecil kemungkinannya mengubah atau menimpa JSON secara tidak semestinya dibanding Markdown, dan prompt-nya menyebut menghapus atau mengedit test sebagai hal yang tidak dapat diterima. [12]
Manus sampai pada file system sebagai context pamungkas, tidak terbatas ukurannya dan persisten secara alami, serta membuat agent-nya terus menulis ulang todo.md agar tujuannya berada di akhir context, dalam jangkauan perhatian terbaru model. Panduan Anthropic menyebut teknik umum ini structured note-taking. Agent saya menyimpan catatannya di luar semua git tree: knowledge stabil yang di-import di awal, learnings yang ditambahkan setelah setiap run, log sesi, dan backlog. Kesalahan saya adalah menggolongkan learnings dan log sesi sebagai run state lalu mengecualikannya dari backup. Padahal keduanya adalah hasil paling berharga dari agent itu, dan hanya ada di satu disk. Sekarang watchdog menyalinnya setiap enam jam. [10, 7]
Git juga merupakan state, dan di sanalah harness saya paling banyak bocor. Run headless tidak punya nanti: ketika sebuah run membuka pull request lalu berakhir sebelum CI selesai, tidak ada yang kembali untuk me-merge-nya. Detector saya hanya melaporkan branch tanpa pull request, sehingga 22 commit menumpuk di empat pull request terbuka tanpa laporan apa pun. Dua perubahan memperbaikinya. Playbook kini mewajibkan gh pr merge --auto, yang diselesaikan GitHub setelah run berakhir, dan detector melaporkan branch tertua yang berada di depan origin/main apa pun status pull request-nya. Branch yang dipulihkan di-triage dengan git cherry, bukan di-merge membabi buta: pada empat branch pertama hasilnya 9, 7, 7, dan 8 commit baru, ditambah satu commit yang ternyata sudah masuk dengan hash berbeda.
# Find stranded work: the oldest branch ahead of main, whatever its PR state.
# Filtering on "no open PR" missed the real case: PR opened, run ended.
git fetch --prune origin
for b in $(git for-each-ref --sort=committerdate --format='%(refname:short)' refs/remotes/origin/agent/); do
  ahead=$(git rev-list --count origin/main.."$b")
  [ "$ahead" -gt 0 ] && { echo "$b $ahead"; break; }
done

# Triage before merging. "+" = not on main yet, "-" = an equivalent patch
# already landed under another hash, so merging blind would duplicate it.
git cherry -v origin/main origin/agent/percentile-coverage
# Example output:
# + 3f2c1a9 test(percentile): cover nearest-rank interpolation edge
# - 8b71e04 test(stats): pin p=100 for a single sample

# Land it after the run exits. GitHub merges once required checks pass,
# so the playbook forbids "I'll watch CI and merge when it is green".
gh pr merge 46 --auto --rebase --delete-branch
Agent bilang selesai itu klaim, bukan bukti
Riset harness design dari Anthropic menyatakan masalahnya dengan lugas: agent secara konsisten condong positif saat menilai pekerjaannya sendiri, dan memisahkan agent yang bekerja dari agent yang menilai terbukti menjadi pengungkit yang kuat. Menyetel evaluator terpisah agar skeptis ternyata jauh lebih mudah daripada membuat generator kritis terhadap dirinya sendiri. Perbandingan biayanya membuat hal ini konkret. Dengan prompt satu kalimat yang sama untuk retro game maker, run solo Opus 4.5 memakan 20 menit dan 9 dolar; harness lengkap dengan planner, generator, dan evaluator memakan 6 jam dan 200 dolar. Aplikasi solo itu tampak selesai. [13]
Bias ini bisa diukur. Panickssery, Bowman, dan Feng menunjukkan di NeurIPS 2024 bahwa evaluator LLM dapat mengenali output-nya sendiri, dan fine-tuning memperlihatkan korelasi linear antara kemampuan mengenali diri itu dan kuatnya preferensi terhadap teks sendiri. Harness long-running Anthropic melihat bentuk praktisnya: Claude menandai fitur selesai setelah unit test atau panggilan curl tanpa memastikan fitur itu berjalan end to end, sampai diminta menguji lewat browser automation seperti yang dilakukan manusia. Kegagalan paling umum di LangChain adalah hal yang sama dalam skala lebih kecil. [14, 12, 5]
Harness saya punya tiga sensor yang tidak berbagi context dengan penulisnya. Pertama, run dinilai dari apa yang sampai ke origin/main, bukan dari exit code-nya, karena run yang sudah me-merge enam commit lalu terkena timeout tetap menyelesaikan tugasnya. Kedua, gate kualitas test. Ketiga, review yang dijalankan sebagai invocation terpisah dan hanya melihat diff. Temuan nyata pertamanya adalah test yang ditambahkan penulis dan mengunci percentileNearestRank(samples, 0), yaitu mengunci perilaku untuk input yang oleh JSDoc fungsi itu sendiri dinyatakan tidak valid, karena rentang validnya (0, 100]. Self-review di sesi penulisan meloloskannya. Di pipeline konten saya, penulis berjalan di Sonnet dan editor di Opus, dan sebuah test memastikan kedua model ID itu berbeda.
#!/usr/bin/env bash
# A minimal test-quality gate, run after the agent's tests are green.
set -euo pipefail

# Compare against the merge-base, never the tip of main. A branch cut days ago
# is legitimately behind a main that has since gained tests.
base=$(git merge-base origin/main HEAD)

count_tests() {
  # git grep exits 1 on zero matches; under pipefail that would abort the gate.
  { git grep -cE '^\s*(it|test)\(' "$1" -- '*.test.ts' || true; } \
    | awk -F: '{ s += $NF } END { print s + 0 }'
}
before=$(count_tests "$base")
after=$(count_tests HEAD)
if [ "$after" -lt "$before" ]; then
  echo "test count dropped against merge-base: $before -> $after" >&2
  exit 1
fi

# A skipped or focused test is a deleted test that still counts as present.
# Herestring, not a pipe: see the pipefail trap further down.
added=$(git diff "$base"...HEAD -- '*.test.ts')
if grep -qE '^\+.*\b(it|test|describe)\.(skip|only)\(|^\+.*\bxit\(' <<< "$added"; then
  echo "added .skip / .only / xit" >&2
  exit 1
fi
Gate ini membandingkan dengan merge-base karena versi pertamanya membandingkan dengan ujung main. Branch yang dibuat beberapa hari sebelumnya wajar tertinggal dari main yang sudah bertambah test-nya, sehingga gate melaporkan penyusutan yang tidak nyata, dan agent yang terus diberi alarm palsu belajar bahwa gate boleh diabaikan.
Uji harness layaknya software, karena memang itu
Mode headless Claude Code keluar dengan 0 saat sukses dan non-zero saat gagal, dan kegagalan di dalam run, misalnya autentikasi yang hilang, dicetak sebagai hasil di stdout. Jadi harness apa pun yang bereaksi pada cara sebuah run berakhir harus membaca output, dan classifier itu adalah kode dengan bug-nya sendiri. Punya saya adalah cerita pembuka tulisan ini. Blok di bawah menunjukkan pola yang salah dan yang benar, ditambah jebakan shell yang membuat self-test harness saya sendiri flaky. [15]
# Wrong: any mention of a rate limit counts as a session cap. Claude Code's
# stream-json carries a rate_limit_info object on EVERY run, healthy ones
# included ("status":"allowed"), and this library's own commits mention
# its RateLimitMiddleware. Healthy runs exited 75 and paused every job.
if grep -qiE 'rate.?limit' "$log.jsonl"; then exit 75; fi

# Right: match the sentence a person sees when the cap is really hit.
if grep -qE "hit your (session|usage) limit|limit reached · resets" "$log.jsonl"; then
  write_cooldown "$log.jsonl"   # parse "resets 2:50am" into epoch seconds
  exit 75                       # EX_TEMPFAIL: not really an error, retry later
fi

# Wrong under set -o pipefail: grep -q exits on its first match, systemctl
# takes SIGPIPE, and pipefail reports the successful match as a failure.
# Only when buffering lines up: it passed 20 runs by hand, then failed under
# the watchdog.
systemctl list-timers --all | grep -q 'library-refine@am.timer'

# Right: a herestring has no pipe for SIGPIPE to break.
grep -q 'library-refine@am.timer' <<< "$(systemctl list-timers --all)"

# And in the unit: a capped run is not a failed unit, and fires no alert.
# [Service]
# SuccessExitStatus=75
Exit code 75 adalah EX_TEMPFAIL di sysexits, kegagalan sementara yang menandakan sesuatu yang sebenarnya bukan error dan perlu dicoba lagi nanti. SuccessExitStatus= di systemd mendaftarkan exit code tambahan yang dihitung sebagai sukses, sehingga run yang terkena cap tidak muncul sebagai unit gagal dan tidak memicu alert. Jebakan pipe ada di definisi pipefail milik Bash: status pipeline adalah status perintah terakhir yang keluar dengan non-zero, sehingga producer yang dimatikan SIGPIPE setelah grep -q menemukan kecocokan mengubah kecocokan yang sukses menjadi kegagalan, tetapi hanya ketika timing-nya pas. Pemeriksaan saya lulus 20 kali saat dijalankan manual dan hanya gagal ketika dijalankan watchdog. [16, 17, 18]
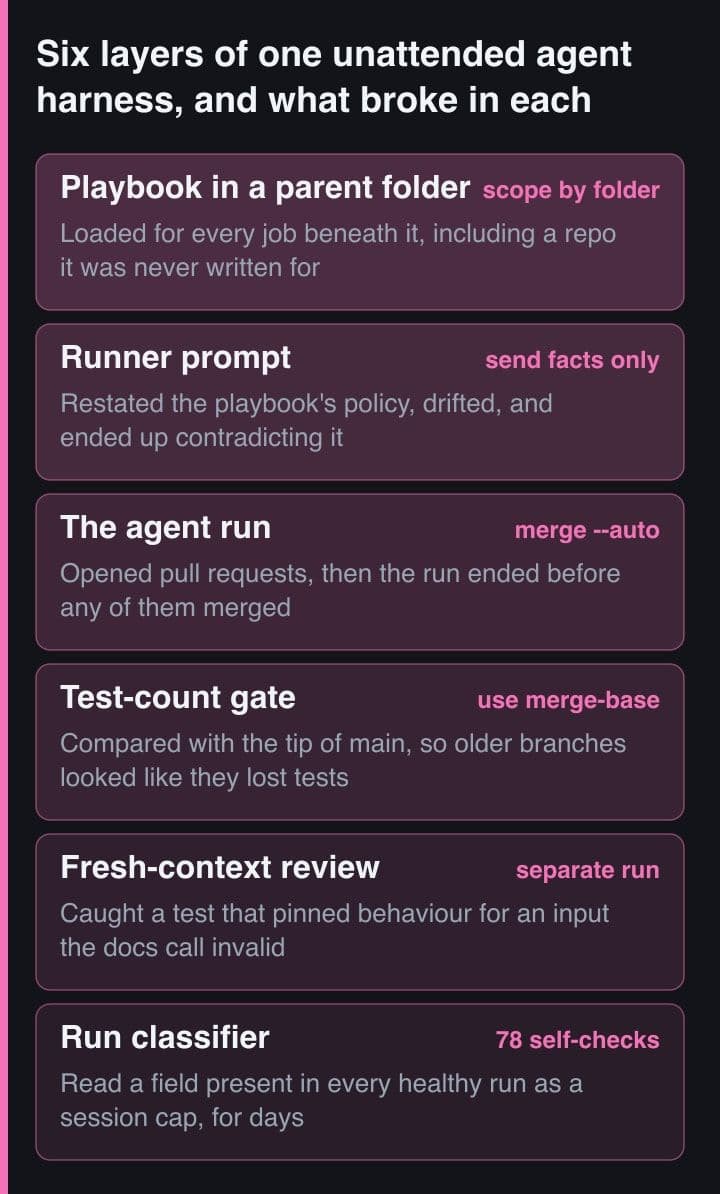
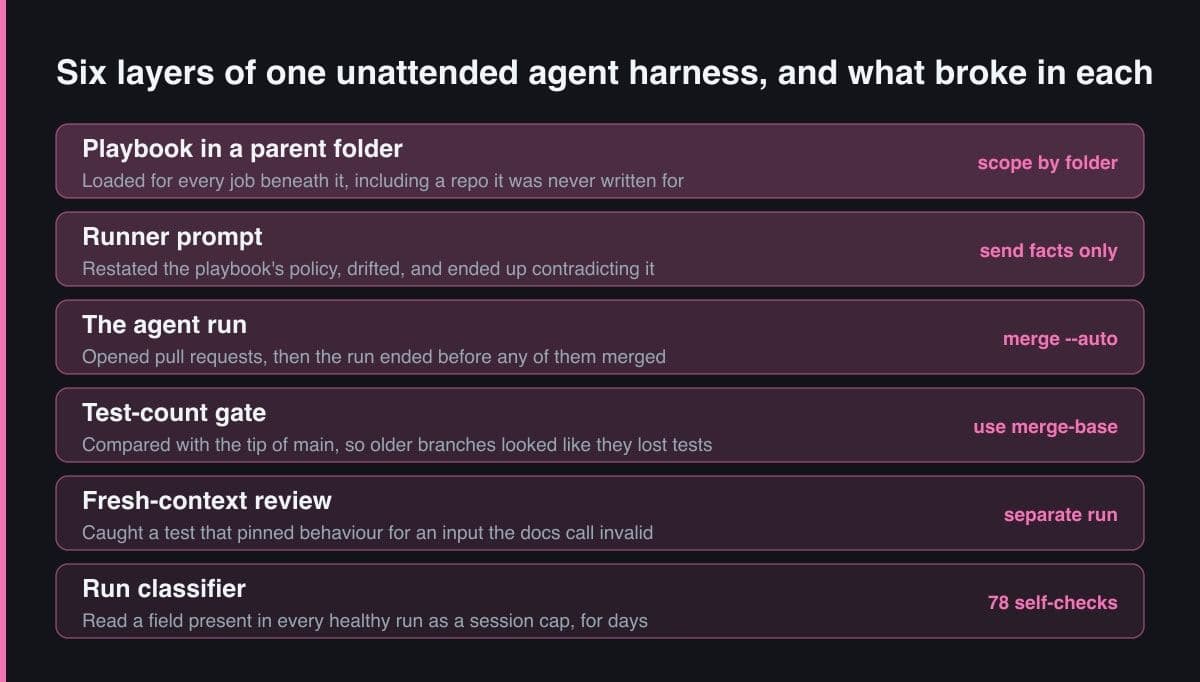
Obat untuk gate yang diam-diam berhenti bekerja adalah test untuk gate itu. Script self-test kini menjalankan 78 pemeriksaan terhadap wiring harness setiap enam jam dari watchdog, termasuk pin model, flag effort, dan skenario driver lab. Versi pertamanya melaporkan tiga kegagalan yang ternyata adalah komentarnya sendiri, yaitu baris yang memperingatkan pola-pola tersebut, sehingga sekarang komentar dibuang sebelum pencocokan. Perubahan runner diuji dengan binary claude tiruan di PATH, yang membuktikan prompt tersusun benar tanpa menghabiskan session budget. Driver lab punya sepuluh skenario hari yang di-sandbox, dan driver lama gagal di kesepuluhnya. Test yang juga diloloskan versi rusak tidak membuktikan apa-apa.
Jangan auto-retry run yang terkena cap langganan. Di setup saya, token dari claude setup-token memakai session limit yang sama dengan sesi interaktif saya sendiri, sehingga retry menghabiskan sisa budget untuk panggilan yang pasti gagal. Tulis cooldown marker berisi waktu reset yang sudah di-parse, buat setiap job memeriksanya lebih dulu, dan jalankan job secara berurutan di balik lock.
Pin modelnya, lalu rencanakan untuk menghapus harness
Dokumentasi Claude Code menyebut alias model mengarah ke versi yang direkomendasikan untuk provider Anda dan berubah seiring waktu, dan cara mem-pin-nya adalah dengan nama model lengkap. Run saya mem-pin claude-sonnet-5-5 dengan effort medium, dan hari peluncuran model itu mengajari saya bahwa CLI juga bagian dari pin. Claude Code di server, versi 2.1.277 di channel stable, belum mengenal ID baru tersebut. Panggilannya berhasil, stderr mencetak peringatan unrecognized_model, dan CLI turun ke context 200K dan 32K output token. Versi 2.1.284 menjalankan ID yang sama di 1M dan 128K. Run headless tidak pernah auto-update. [19]
# Headless runs never auto-updated, so update the CLI before trusting a new
# model ID. A build that does not know the ID still answers; it just prints
# [claude-code:unrecognized_model] on stderr and quietly runs smaller.
claude install 2.1.284

# Probe once and read what the CLI actually granted.
claude -p "reply with ok" --model claude-sonnet-5-5 --effort medium \
  --output-format json \
  | jq '.modelUsage["claude-sonnet-5-5"].contextWindow'
# 1000000 on 2.1.284; 200000 on the stable build that did not know the ID
Poin jangka panjangnya datang dari tulisan harness design Anthropic: setiap komponen harness menyimpan asumsi tentang apa yang tidak bisa dilakukan model sendirian, dan asumsi itu bisa cepat basi seiring membaiknya model. Penulisnya menghapus context reset setelah Opus 4.5 tidak lagi menunjukkan context anxiety, membuang konstruksi sprint untuk Opus 4.6, dan mendapati evaluator menjadi overhead yang tidak perlu untuk tugas yang masih dalam kemampuan solo model, sambil tetap sepadan biayanya di tepi kemampuan itu. The Bitter Lesson dari Rich Sutton adalah versi panjang dari peringatan yang sama: menanamkan cara kita mengira kita berpikir tidak berhasil dalam jangka panjang. [13, 20]
| Run Anthropic | Model | Waktu | Biaya | Hasilnya |
|---|---|---|---|---|
| Agent solo, retro game maker | Opus 4.5 | 20 mnt | $9 | Tampak lengkap; level-nya tidak bisa dimainkan |
| Harness lengkap: planner, generator, evaluator, sepuluh sprint | Opus 4.5 | 6 jam | $200 | Spesifikasi 16 fitur terbangun, bisa dimainkan dengan fisika yang kasar |
| Harness disederhanakan tanpa sprint, DAW di browser | Opus 4.6 | 3 jam 50 mnt | $124,70 | Aplikasi berbeda; builder berjalan koheren lebih dari dua jam tanpa putus |
Asumsi basi saya sendiri soal cakupan, bukan kemampuan. Selama sepuluh hari sejak 28 September, setiap run job library mencatat langkah berikutnya yang sama dan tidak menghasilkan apa pun. Coverage sudah jenuh di 98,86%, dan playbook melarang satu-satunya pekerjaan yang tersisa: upgrade major dev-dependency dan apa pun yang menyentuh CI merah. Modelnya mau; harness-nya melarang. Playbook kini menyerahkan upgrade kepada agent, termasuk major bump yang terkoordinasi sebagai satu pull request, dan menjadikan backlog sebagai pekerjaan ketika menu habis. Rilis major npm tetap keputusan manusia.
Audit yang kini saya jalankan pada harness apa pun, dengan urutan ini:
- Tulis, untuk setiap komponen, asumsi yang disimpannya dan pengamatan yang akan membuatnya pensiun.
- Pin model ID yang persis, update CLI sebelum memakai model baru, dan cek context window yang benar-benar diberikannya.
- Buat instruksi pendek dan terlingkup berdasarkan lokasi, dan biarkan runner mengirim fakta, jangan salinan kedua dari kebijakan.
- Pasang minimal satu sensor di luar context penulis: pemeriksaan deterministik dulu, lalu reviewer yang dipanggil terpisah, idealnya di model berbeda.
- Nilai run dari apa yang berhasil masuk, bukan dari exit code, dan beri harness test-nya sendiri dengan model tiruan.
Model mendapat sorotan, tetapi harness-lah yang menentukan apa yang dilihat model, apa yang boleh dilakukannya, dan apakah ada yang menyadari saat ia keliru. Hasil yang dipublikasikan sejalan dengan log saya: tahan modelnya tetap, dan harness masih menggeser hasil, hingga 13,7 poin dalam run yang dikutip di sini. Saat agent mengecewakan, debug harness lebih dulu. Saat model baru dirilis, periksa bagian harness mana yang kini tidak lagi diperlukan.
Terkait di situs ini
- Verification loop: keterampilan inti agentic coding
- Context engineering untuk AI coding agent di monorepo
- Hook deterministik vs penilaian agent di Claude Code
Sumber
- Birgitta Böckeler, Harness engineering for coding agent users (martinfowler.com, 2026)
- Anthropic, Building effective agents (2024)
- OpenAI, Harness engineering: leveraging Codex in an agent-first world (2026)
- Yang dkk., SWE-agent: agent-computer interfaces enable automated software engineering (arXiv 2405.15793)
- LangChain, Improving Deep Agents with harness engineering (2026)
- Terminal-Bench: benchmark dan leaderboard-nya
- Anthropic, Effective context engineering for AI agents (2025)
- Chroma, Context Rot: how increasing input tokens impacts LLM performance (2025)
- Liu dkk., Lost in the Middle: how language models use long contexts (TACL)
- Manus, Context engineering for AI agents: lessons from building Manus (2025)
- Dokumentasi Claude Code: How Claude remembers your project
- Anthropic, Effective harnesses for long-running agents (2025)
- Anthropic, Harness design for long-running application development (2026)
- Panickssery, Bowman, dan Feng, LLM evaluators recognize and favor their own generations (NeurIPS 2024)
- Dokumentasi Claude Code: Run Claude Code programmatically
- Manual FreeBSD: sysexits(3)
- Manual systemd: systemd.service dan SuccessExitStatus=
- Manual GNU Bash: pipeline dan pipefail
- Dokumentasi Claude Code: model configuration
- Rich Sutton, The Bitter Lesson (2019)