

Ringkasan Utama
Command claude plugin eval di Claude Code menjalankan eval case yang dinilai terhadap sebuah plugin dan, secara default, menjalankan ulang setiap case tanpa plugin apa pun. Arm kedua itulah yang membuktikan plugin benar-benar berpengaruh. Plugin yang dirilis tanpa langkah ini gagal tanpa suara: skill terpasang, tidak pernah aktif, dan tidak ada yang melapor.
Saya merilis sebuah plugin ke tiga rekan kerja dan dua minggu berikutnya sunyi. Tidak ada laporan bug, tidak ada pertanyaan, tidak ada keluhan. Ketika akhirnya saya tanya, ketiganya sudah memasang dan mengaktifkannya, dan tidak satu pun pernah melihat plugin itu melakukan apa-apa. Skill di dalamnya sama sekali belum pernah aktif.
Plugin adalah dependency yang dipasang orang lain, dan itu sebabnya yang dibutuhkan adalah test suite, bukan demo. Tulisan ini membahas bentuk sebuah eval case, cara membaca ablation arm tanpa plugin, apa yang diberikan report dan exit code untuk CI, serta cacat di balik dua minggu sunyi saya. Belum ada halaman dokumentasi publik untuk claude plugin eval, jadi semua flag dan path di bawah ini saya ambil dari claude plugin eval --help pada Claude Code 2.1.259, dan saya sebutkan setiap kali sebuah klaim tidak ada di dokumentasi resmi.
Apa yang sebenarnya dibuktikan oleh install yang lancar
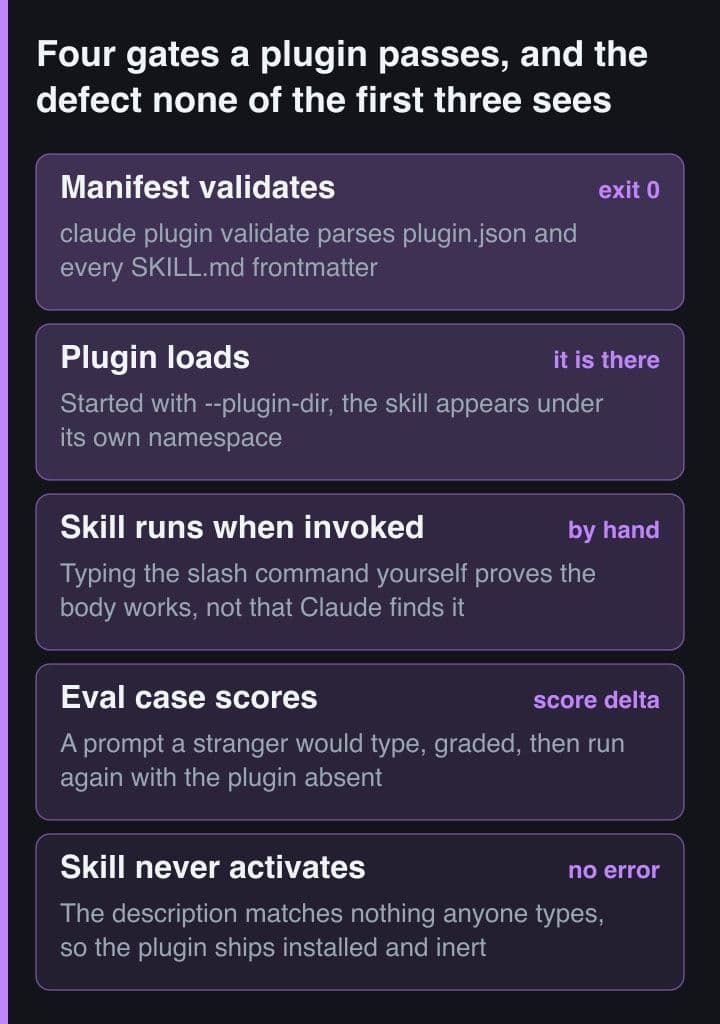
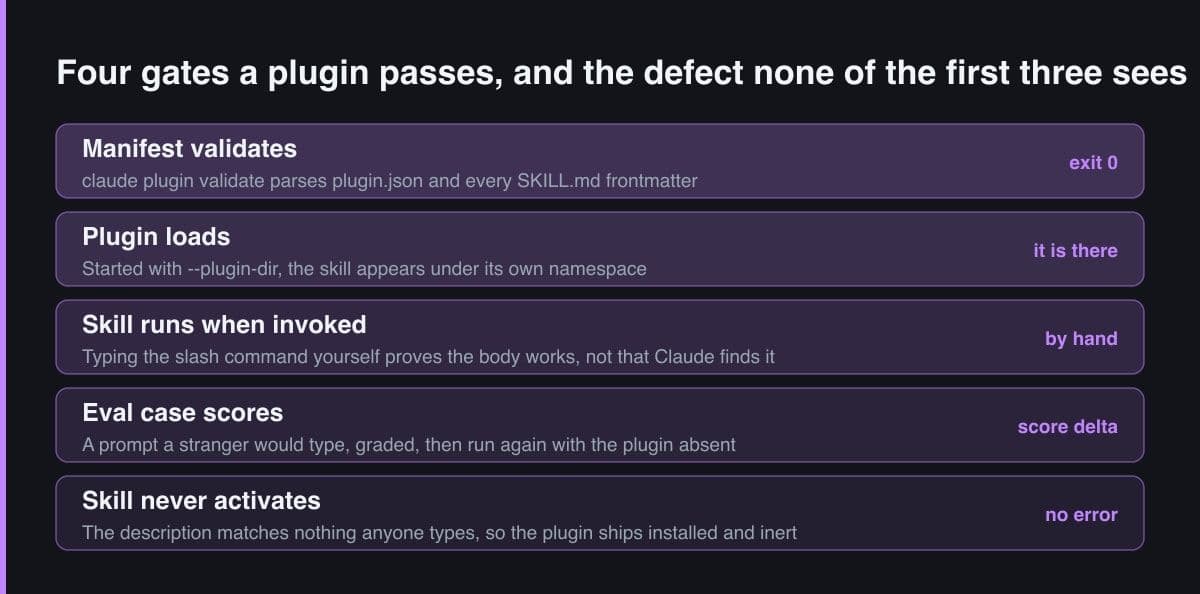
Semua pemeriksaan yang saya jalankan sebelum merilis adalah pemeriksaan struktur. Flag --plugin-dir memuat direktorinya, skill muncul di menu help dengan namespace-nya, mengetik slash command secara manual menghasilkan output yang saya inginkan, dan claude plugin validate lolos. Keempat hal itu sama benarnya untuk plugin yang tidak akan pernah dipicu siapa pun, dan justru bagian itu yang tidak saya pikirkan.
# One skill. A description that resembles nothing a user would type.
$ cat receipt-tools/skills/format-receipt/SKILL.md
---
description: Format a thermal receipt
---
Format the receipt.

$ claude plugin validate ./receipt-tools
Validating plugin manifest: .../receipt-tools/.claude-plugin/plugin.json

⚠ Found 1 warning:

  ❯ author: No author information provided. Consider adding author details
    for plugin attribution

✔ Validation passed with warnings
$ echo $?
0

# --strict promotes that warning to a failure. Note what changed: the missing
# author field. Not one byte of the description was examined.
$ claude plugin validate ./receipt-tools --strict
✘ Validation failed (--strict treats warnings as errors)
$ echo $?
1
Dokumentasi skills merangkum celahnya dalam satu kalimat: melihat sebuah skill aktif hanya membuktikan Claude menemukannya, bukan bahwa hasilnya sesuai maksud Anda. Kebalikannya justru yang lebih mahal, dan tidak ada validator yang menjangkaunya. Description adalah persoalan pencocokan — mirip atau tidak mirip dengan kalimat yang diketik pengguna Anda — dan mem-parse frontmatter tidak bisa membedakan description yang cocok dengan prompt nyata dari description yang berbunyi seperti nama file.
Sebuah eval case adalah satu prompt plus sekumpulan grader
Eval suite adalah direktori berisi case, dan satu case adalah satu prompt plus kriteria untuk menilai jawabannya. Harness membacanya dari eval dir, default-nya evals/, yang bisa dipindah dengan --eval-dir atau lewat manifest plugin. Setiap direktori case berisi case.yaml, atau pasangan yang lebih sederhana seperti yang disebut help text untuk template kosong: satu prompt.md yang isi filenya adalah prompt itu sendiri, dan satu direktori graders/ berisi file markdown yang frontmatter-nya menyatakan type.
#   evals/                       the eval dir; --eval-dir moves it
#     58mm-receipt/
#       prompt.md                the prompt to test
#       graders/columns.md       what a good answer looks like
#     sprint-report/
#       prompt.md                a prompt this skill must NOT claim
#       graders/quiet.md

# evals/58mm-receipt/prompt.md — the body of the file IS the prompt.
Print this order as a receipt for the till. The paper is 58 mm.

# Wrong, and it is the usual first draft:
#   Use the format-receipt skill to print this order as a receipt.
# A prompt that names the skill cannot test whether Claude would have found
# the skill. It grades the body of a skill you already told it to load, which
# is the one thing that was never in doubt.

# evals/58mm-receipt/graders/columns.md
---
type: llm
weight: 1
---
No line of the receipt is wider than 32 characters, and the order total is
right-aligned on a line of its own.
Tulis prompt seperti kalimat yang benar-benar akan dikirim pengguna, dan tahan keinginan menyebut nama skill Anda sendiri di dalamnya. Menyebut namanya adalah draf pertama saya untuk setiap case, dan itu lebih buruk daripada tidak punya test sama sekali: prompt yang berbunyi pakai skill format-receipt hanya menilai isi skill yang sudah Anda suruh Claude muat. Simpan juga satu case yang skill Anda harus diam, karena suite yang isinya hanya prompt should-trigger memberi nilai bagus pada description yang aktif di segala hal.
Ablation arm adalah bagian yang menguji activation
Default-nya dua arm per case, bukan satu. Setiap kali target berhasil di-resolve sebagai plugin — lewat path, lewat nama, atau lewat pasangan plugin dan marketplace — harness menambahkan baseline arm tanpa plugin dan melaporkan selisih skor antara keduanya. Memberi --ablation none mengembalikannya ke penilaian satu arm, tapi selisih itulah angka yang berharga, karena hanya selisih yang memisahkan plugin yang berguna dari model yang sebenarnya sudah bisa mengerjakannya sendiri.
# Default when the target resolves to a plugin: every case runs twice.
$ claude plugin eval ./receipt-tools
#   arm 1  the case with the plugin loaded
#   arm 2  the same case with no plugin at all
# and the run reports the score delta between them.

# Single-arm scoring, if you only want the plugin's own number:
$ claude plugin eval ./receipt-tools --ablation none

# Under with-without a grader marked with-only becomes a plugin-fired
# INDICATOR, not part of the score — the baseline arm has no skill to fire,
# so scoring it would measure the ablation rather than the plugin.

# Three readings of one pair of numbers:
#   with 0.91, without 0.89   the model did it anyway — the skill is decoration
#   with 0.91, without 0.24   the plugin is doing the work
#   with 0.22, without 0.22   plus a cold indicator — the skill never fired
Ini metode yang sama dengan yang disarankan dokumentasi skills secara manual: kumpulkan prompt yang realistis, jalankan masing-masing di session baru dengan skill tersedia lalu ulangi dengan skill dimatikan, kemudian bandingkan. Session baru itu penting, karena context sisa dari proses menulis skill menutupi lubang pada instruksi yang sebenarnya Anda tulis. Harness melakukannya per case dan tiga kali masing-masing secara default, jumlah pengulangan yang kira-kira sama dengan batas kesabaran saya kalau dikerjakan manual.
Membaca kegagalan: threshold, report, exit code
Satu run menulis aggregate result di bawah eval dir dan sebuah HTML report yang berdiri sendiri sehingga bisa dikirim ke mana saja. Untuk sebuah gate, dua flag yang penting adalah --threshold, yang keluar dengan exit 1 begitu ada case bernilai di bawah angka yang Anda beri, dan --max-cost-usd, yang membatalkan run dengan exit 2 serta melaporkan hasil sebagian ketimbang membiarkan biaya membengkak. Default threshold adalah 1.0, lebih ketat daripada yang bisa dilewati suite nyata mana pun, jadi pilih angka yang memang Anda rela pakai untuk memblokir rilis.
# Results land under the eval dir by default:
#   ./evals/results/<timestamp>/aggregate-result.json
# --report writes the self-contained HTML (scores, prompts, grader verdicts)
# somewhere you name instead, and --json prints or writes the full run result:
# prompts, graders and per-run scores.

$ claude plugin eval ./receipt-tools \
    --json    ./eval-run.json \
    --report  ./eval-report.html \
    --no-publish \
    --threshold 0.8 \
    --runs 5 \
    --case '58mm-*'

# The exit codes are the reason this can be a gate at all:
#   0   nothing scored below --threshold
#   1   at least one case scored below it (--threshold defaults to 1.0)
#   2   the --max-cost-usd ceiling was hit; partial results are reported

# --no-publish matters for an internal plugin: publishing the HTML report to
# claude.ai is already the default wherever the account supports it.| Type grader | Apa yang dipastikannya | Apa yang tidak bisa dijawabnya |
|---|---|---|
| regex | Jawaban memuat, tidak memuat, atau memuat tepat N kali sebuah pattern yang Anda tulis | Apakah kata-kata yang cocok itu muncul karena alasan yang benar |
| tool_order | Satu tool dipanggil sebelum tool lain di dalam trace run | Apakah salah satu dari dua panggilan itu memang perlu |
| tool_used | Sebuah tool dipanggil, dan berapa kali ia dipanggil | Apa yang diminta ke tool itu, atau apa yang dikembalikannya |
| file_exists | Run meninggalkan file di lokasi yang disebut case | Apa pun tentang isi file tersebut |
| llm | Sebuah model menilai jawaban terhadap kriteria lulus yang Anda tulis dalam prosa | Apa pun yang bisa diulang dari satu run saja, dan itu alasan default runs-nya tiga |
| baseline | Jawaban dinilai terhadap sebuah referensi, bukan terhadap kriteria tertulis | Apakah referensi itu masih jawaban yang Anda inginkan hari ini |
Baca case yang gagal dari type grader-nya dulu sebelum membaca skornya, karena enam type itu gagal dengan alasan yang berbeda dan hanya dua di antaranya berbiaya. Help text menyebut dengan jelas bahwa llm dan baseline adalah grader berbayar: ketika batas biaya tembus di tengah run, keduanya dilewati dan grader gratis tetap menilai run tersebut. Rancang suite Anda mengikuti asimetri itu. Taruh assertion mekanis yang murah pada perilaku yang paling Anda pedulikan, dan simpan kriteria berbentuk prosa untuk bagian yang hanya bisa dinilai model.
Jalankan suite baru sekali dengan --ablation none sebelum mempercayai selisih apa pun. Case yang skornya buruk di kedua arm biasanya berarti case-nya rusak, bukan plugin-nya, dan angka satu arm memberi tahu Anda yang mana tanpa harus membaca dua kolom penilaian grader.
Hal-hal yang harness menolak lakukan untuk Anda
Kejutan yang menyenangkan adalah betapa sedikitnya eval harness ini mempercayai file case. Bash, Write, Edit, WebFetch dan semua tool MCP dijaga di balik operator grant yang eksplisit di command line, dan grant itu menerima pattern, bukan seluruh tool. Sebuah case juga boleh membawa scaffold script untuk menyiapkan fixture-nya, dan script itu berjalan sebagai Anda, jadi ia tidak dieksekusi sama sekali kecuali Anda memberi --scaffold. Help text menyebutkannya terang-terangan: pakai hanya pada file case yang Anda tulis sendiri.
# The agent under test does not get your shell. Bash, Write, Edit, WebFetch
# and mcp__* are gated behind an operator grant, and it takes patterns:
$ claude plugin eval ./receipt-tools \
    --allow-tools Read Glob Grep \
    --allow-tools 'Bash(printf:*)'

# A case may carry a scaffold_script. It runs as YOU, so it is off unless you
# ask, and the help says exactly when to ask: only on cases you authored.
$ claude plugin eval ./receipt-tools --scaffold

# MCP servers get stand-ins by default, read from the eval dir's mocks/.
# Turning that off spawns the real ones, still gated by --allow-tools:
$ claude plugin eval ./receipt-tools --mocks off --allow-tools 'mcp__jira__*'

# When a run behaves strangely, keep the scaffold directories and read them:
$ claude plugin eval ./receipt-tools --keep-temp
Server MCP diberi stand-in secara default, dibaca dari direktori mocks di dalam eval dir, dan itulah bedanya antara suite yang bisa dijalankan setiap rilis dengan suite yang membuat ticket sungguhan setiap kali. Mematikan mocks akan menjalankan server yang sebenarnya, tetap dijaga oleh --allow-tools, jadi ada dua kunci antara file case dan Jira production Anda. Kalau sebuah run berperilaku aneh, --keep-temp menyimpan direktori scaffold sehingga Anda bisa membaca apa yang benar-benar dilakukan case itu.
Eval run tidak gratis dan default-nya berlipat. Setiap case berjalan tiga kali kecuali Anda ubah, kedua ablation arm berjalan untuk masing-masingnya, dan setiap grader llm atau baseline adalah panggilan model tambahan. Pasang --max-cost-usd pada run pertama suite baru, bukan setelah tagihan datang: batas itu membatalkan run dengan exit 2 dan tetap melaporkan hasil sebagiannya.
Memasangnya di CI sebagai release gate
Pecah gate-nya jadi dua, karena kedua bagian punya biaya yang sangat berbeda. Command validate gratis, non-interaktif dan cepat, jadi tempatnya di setiap push. Saya mengukurnya keluar dengan exit 0 saat ada warning dan exit 1 dengan --strict, sehingga versi --strict itulah yang layak dipasang di job. Suite yang dinilai memanggil model, jadi ia menjaga release tag, dan claude plugin tag memberi Anda bentuk tag untuk dicocokkan: ia menulis tag berisi nama dan versi hanya setelah plugin.json dan entry marketplace di sekitarnya sepakat.
# .github/workflows/plugin-release.yml
name: plugin-release
on:
  push:
    branches: [main]
    tags: ['*--v*']          # the shape claude plugin tag creates
jobs:
  # Free, so it runs on every push. Catches a manifest or frontmatter defect
  # in seconds and never makes a model call.
  structure:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: npm install -g @anthropic-ai/claude-code
      - run: claude plugin validate ./plugins/receipt-tools --strict

  # Not free: each case runs three times by default and the LLM graders are
  # model calls. So it gates the release tag, not the branch.
  evals:
    needs: structure
    if: startsWith(github.ref, 'refs/tags/')
    runs-on: ubuntu-latest
    env:
      ANTHROPIC_API_KEY: ''   # from repository secrets
    steps:
      - uses: actions/checkout@v4
      - run: npm install -g @anthropic-ai/claude-code
      - run: |
          claude plugin eval ./plugins/receipt-tools \
            --report ./eval-report.html \
            --json   ./eval-run.json \
            --no-publish \
            --threshold 0.8 \
            --max-cost-usd 5
      - uses: actions/upload-artifact@v4
        if: always()          # the report is most wanted when the job failed
        with:
          name: eval-report
          path: eval-report.html
Satu catatan jujur soal workflow itu. Command eval masih early access. Di akun saya, command-nya ada, flag-nya terbaca, lalu ia keluar dengan exit 1 dan pesan bahwa plugin eval sedang early access, jadi job di atas adalah gate yang strukturnya saya tulis dan periksa, bukan yang sudah saya lihat berwarna hijau. Bagian validate berjalan hari ini di semua install sejak v2.1.233, versi yang mengajarinya memeriksa frontmatter di direktori skills tanpa manifest.
Cacat yang lolos kalau langkah ini dilewati
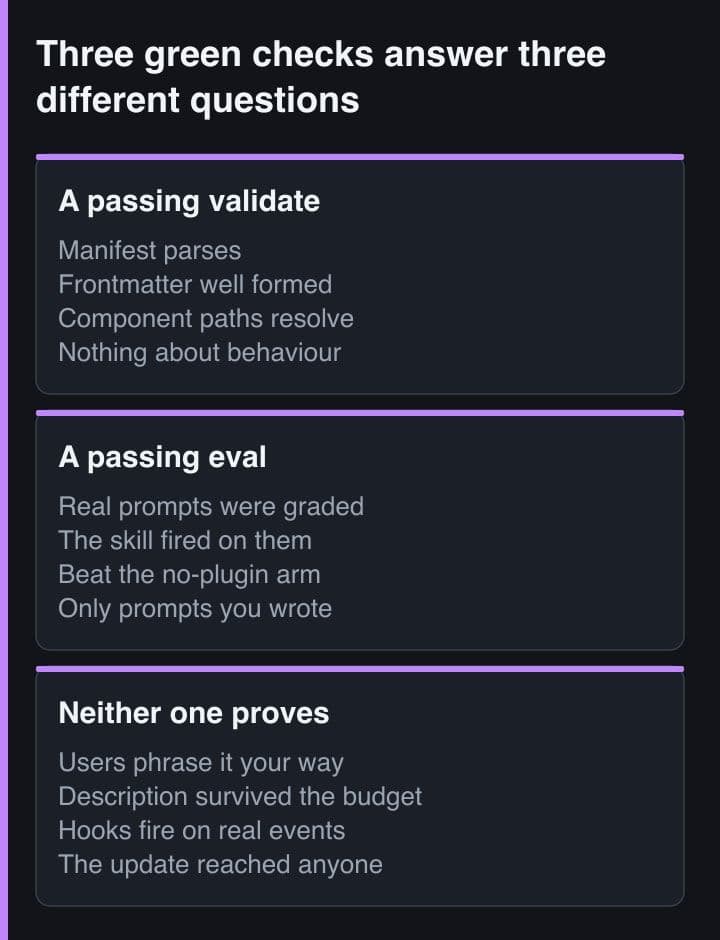
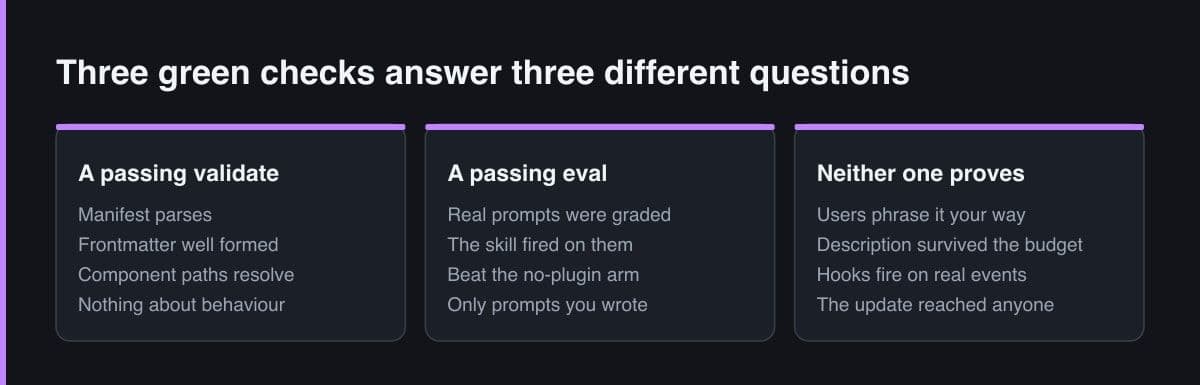
Dua minggu sunyi saya punya satu penyebab: description yang ditulis untuk saya sendiri, bukan untuk orang yang akan memasangnya. Description itu menjelaskan skill-nya dengan kosakata skill tersebut, sementara rekan kerja saya mengetik kosakata masalah mereka. Kedua sisi tidak salah dan tidak ada yang error, dan justru karena itu masalahnya bertahan dua minggu. Tooling Anthropic sendiri memperlakukan ini sebagai cacat utama sebuah skill. Plugin skill-creator menghasilkan prompt should-trigger dan should-not-trigger, mengukur hit rate-nya, lalu mengusulkan perbaikan description, dan Anthropic melaporkan bahwa penerapannya pada enam skill pembuat dokumen yang publik memperbaiki triggering pada lima di antaranya.
# A should-not-trigger case has no positive grader in it at all.
# evals/sprint-report/prompt.md
Print the sprint report as a PDF for the standup.

# evals/sprint-report/graders/quiet.md
---
type: llm
weight: 1
---
The answer does not format a thermal receipt and does not discuss column
widths or paper width.

# Neither case can see the failure upstream of both of them, so read that
# one out of the session instead of out of a report:
#   /context   the Skills row, sized AFTER the listing budget is applied
#   /doctor    what the listing costs, and its biggest contributors
Ada versi lanjutan dari kegagalan yang sama, yang tidak bisa ditangkap eval case mana pun di mesin Anda, karena kejadiannya sebelum model membaca description Anda. Claude Code memuat nama dan description skill ke dalam sebuah listing dengan budget satu persen dari context window model, dan ketika listing itu melebihi budget, description mulai dibuang dari skill yang paling jarang Anda panggil. Plugin Anda, menurut definisinya, adalah yang paling jarang dipanggil pengguna baru — jadi di mesin yang sibuk ia bisa tercantum hanya dengan namanya, tanpa satu pun keyword yang seharusnya cocok dengan prompt. Empat pemeriksaan berikut sekarang berdiri antara plugin saya dan sebuah rilis.
- Tulis dua case per skill sebelum menulis fitur ketiga: satu prompt yang harus diklaim skill itu, dengan kata-kata orang lain dan bukan kata-kata Anda, dan satu prompt serupa yang skill itu harus diam.
- Jalankan suite dengan ablation arm aktif dan baca selisihnya, bukan skornya. Case yang lolos di kedua arm berarti skill itu tidak menopang apa-apa; case yang gagal di kedua arm berarti case-nya yang salah.
- Periksa indikator activation, bukan hanya angkanya. Grader with-only pada tool Skill yang tidak pernah menyala berarti plugin-nya tidak pernah aktif, dan itu bug yang berbeda dari aktif lalu menjawab dengan buruk.
- Buka laporan context di mesin yang sudah punya banyak skill lain, baca baris Skills, dan taruh use case utama di awal description supaya pemotongan mengambil kata-kata yang paling tidak berguna, bukan keyword Anda.
Aturan yang saya bawa dari kejadian ini pendek: plugin adalah dependency, dan dependency yang gagal tanpa suara lebih buruk daripada yang crash. Uji activation sebelum perilaku, simpan satu case should-not-trigger per skill, jaga setiap push dengan pemeriksaan struktur yang gratis dan release tag dengan suite yang dinilai, lalu baca selisihnya alih-alih skornya. Plugin yang tidak diuji tidak gagal dengan berisik. Ia hanya duduk di sana, terpasang dan mati, sementara semua orang menganggapnya bekerja.
Sumber dan bacaan lanjutan
- Dokumentasi Claude Code — Agent Skills, termasuk cara mengevaluasi dan menyempurnakan sebuah skill
- Dokumentasi Claude Code — Create plugins, termasuk pengujian lokal dan validasi
- Dokumentasi Claude Code — Plugins reference, termasuk debugging and development tools
- Plugin skill-creator — anthropics/claude-plugins-official di GitHub
- Anthropic — Improving skill-creator: test, measure and refine agent skills