

Ringkasan Utama
Di managed PaaS tidak ada SSH, jadi debugging production sepenuhnya bergantung pada apa yang ditulis proses ke stdout. Tulis satu JSON object per baris, bawa satu correlation ID lintas service, flush stream sebelum proses berhenti, dan kirim salinannya ke luar platform, karena semua itu tidak bisa ditambahkan saat insiden sedang berjalan.
Pukul 02.40 hari Selasa, endpoint approval sebuah ERP API mulai mengembalikan 500 ke satu customer saja dan tidak ke yang lain. Refleks pertama saya adalah kebiasaan lama: buka terminal, ssh ke server, tail file log. Servernya tidak ada. Service itu berjalan di managed platform, dan satu-satunya hal antara saya dan kegagalan tadi adalah tab browser yang menstream baris dari empat pod sekaligus, tanpa satu pun yang menyebut asalnya.
Akhirnya ketemu juga, dan bagian yang lambat itu murni kesalahan saya sendiri beberapa bulan sebelumnya, di dalam kode. Tulisan ini berisi apa yang saya ubah setelahnya: konfigurasi logger, correlation ID, perilaku buffering yang menelan baris terakhir sebelum crash, dan checklist yang harus sudah benar sebelum pager berbunyi. Detail platformnya berasal dari pengalaman men-deploy NestJS ERP API dan front end Next.js ke Helipod, PaaS Indonesia yang berjalan di atas Kubernetes dan menyediakan log streaming serta terminal lewat browser, bukan SSH.
Apa yang sebenarnya hilang ketika SSH dicabut
Yang hilang bukan shell-nya. Yang hilang adalah riwayat dan kemampuan mencari. Shell hanya cara untuk menjangkau state, dan pada pod yang sehat web terminal platform sudah mengembalikan itu. Yang tidak pernah dikembalikan oleh managed platform mana pun adalah file log: artefak yang tahan lama, bisa digeser posisinya, bisa di-grep, dan tetap ada setelah proses yang menulisnya mati. Live stream itu sebuah tail, dan tail hanya menjadi bukti kalau ada yang sedang menontonnya.
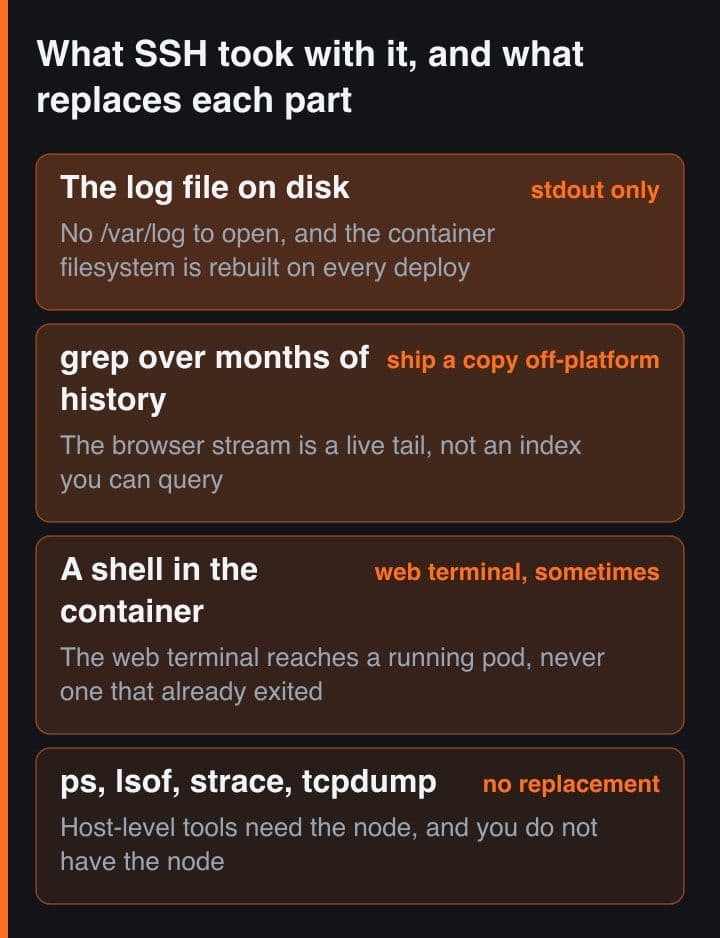
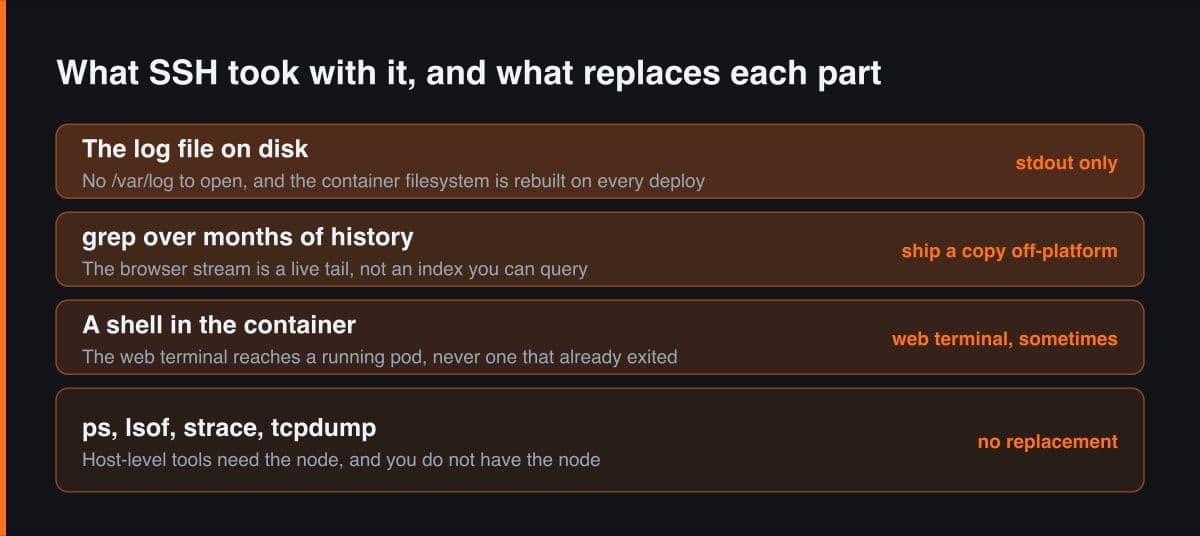
- File di disk. Tidak ada /var/log untuk dibuka, dan filesystem container dibangun ulang dari image setiap kali deploy.
- grep, awk, dan less atas riwayat berbulan-bulan. Stream di browser adalah live tail dalam jendela waktu yang pendek, bukan index yang bisa Anda query.
- Shell di dalam container yang sudah keluar. Web terminal hanya menempel ke pod yang sedang berjalan, sedangkan pod yang crash justru lebih sering dalam keadaan tidak berjalan.
- Tooling level host. ps, lsof, strace, dan tcpdump semuanya butuh node, dan di managed platform Anda tidak memegang node.
Saya tidak mau kembali ke cara lama. Menghilangkan SSH menghilangkan satu kategori pekerjaan sekaligus: tidak ada key yang harus dirotasi, tidak ada bastion, tidak ada fail2ban, tidak ada server yang perlahan menyimpang dari Dockerfile-nya sendiri. Tetapi keempat kehilangan tadi sekarang harus dibayar di depan, di dalam kode aplikasi, atau tidak terbayar sama sekali. Itu perubahan yang sesungguhnya, dan itu pula bagian yang paling gampang baru disadari pada waktu paling buruk.
Satu JSON object per baris, atau stream itu tidak terbaca
Stream yang berbasis baris hanya bisa dicari sejauh barisnya menjelaskan dirinya sendiri. Ketika empat replica menulis ke satu stream yang sama, yang membuat sebuah baris berguna adalah konteks yang dibawanya: siapa yang menulis, dari build mana, untuk request yang mana. Newline-delimited JSON memberi itu, satu object utuh per baris, dan formatnya dibaca semua log backend tanpa konfigurasi tambahan serta bisa langsung dibaca jq dari file hasil export. Ini konfigurasi pino yang sekarang saya salin ke setiap service.
// logger.ts - the only thing in this service allowed to write to stdout.
import pino from "pino";

export const logger = pino({
  level: process.env.LOG_LEVEL ?? "info",
  // Keep the NUMERIC level: pino routes per-target on it and jq compares it.
  // levelName is the extra field, for the human doing a plain-text search.
  formatters: {
    level: (label, number) => ({ level: number, levelName: label }),
  },
  timestamp: pino.stdTimeFunctions.isoTime,
  base: {
    service: "erp-api",
    env: process.env.NODE_ENV,
    // The git SHA the image was built from. Without it you cannot tell
    // whether the line you are reading came from the build you just shipped.
    release: process.env.GIT_SHA,
  },
  // Paths, not guesses. NIK is an Indonesian national ID number and must
  // never reach a log aggregator you do not own.
  redact: [
    "req.headers.authorization",
    "req.headers.cookie",
    "body.password",
    "customer.nik",
  ],
  // One line per error, stack included as a string field - see below.
  serializers: { err: pino.stdSerializers.err },
});| Field | Contoh nilai | Gunanya jam 3 pagi |
|---|---|---|
| time | 2026-09-25T02:40:11.418Z | Menyusun satu cerita saat empat pod menulis berselang-seling |
| level | 50 | Menyaring stream sampai tersisa error tanpa perlu membacanya |
| service | erp-api | Menyebut app mana yang menulis baris itu, sebelum Anda menebak |
| release | a1c9f2e | Menjawab apakah perbaikan yang baru dikirim memang sudah jalan |
| traceId | 0af7651916cd43dd8448eb211c80319c | Menyambung baris ini ke service lain yang melayani request sama |
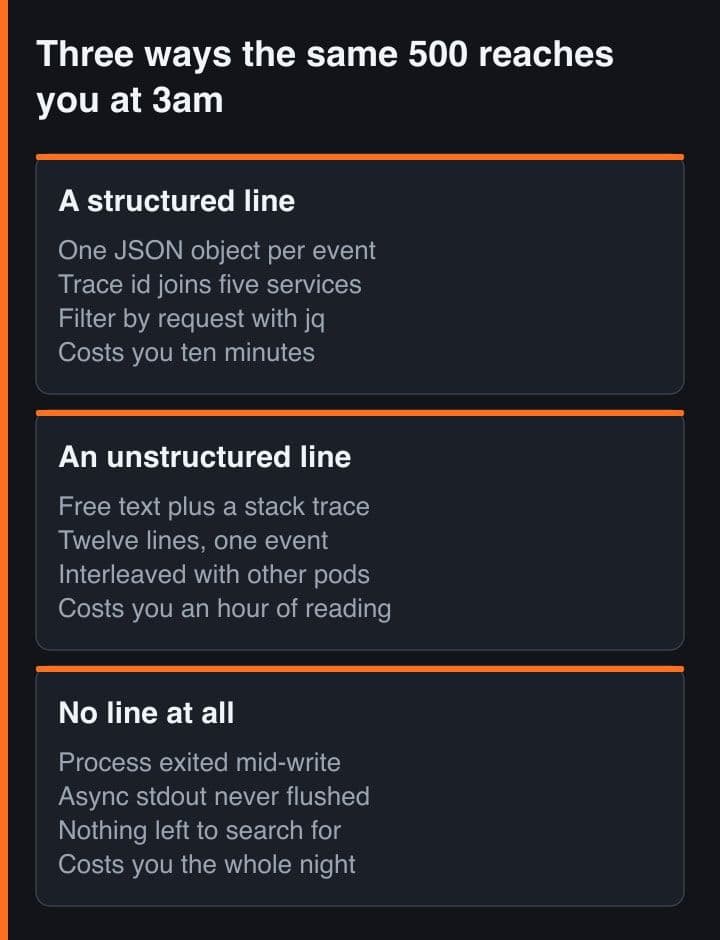
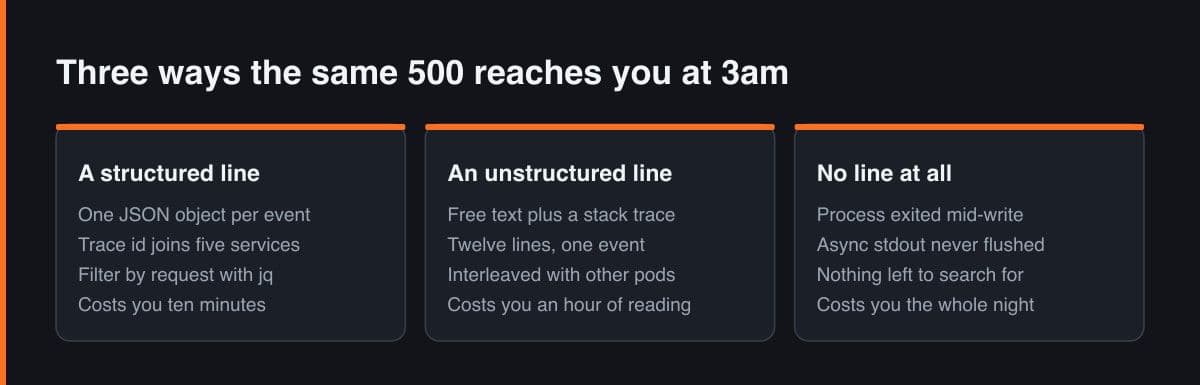
Field yang paling lama saya tolak sendiri adalah release. Separuh insiden yang terasa lambat menjadi lambat karena saya tidak bisa memastikan apakah baris log di depan mata berasal dari build yang bermasalah atau build yang sudah diperbaiki, sementara saya membaca stream dari rolling deploy yang membuat keduanya hidup bersamaan. Tujuh karakter git SHA di setiap baris menyelesaikan itu dengan satu perintah jq, bukan sepuluh menit menatap timestamp.
Stack trace multi-baris adalah musuh stream berbasis baris
Di stream yang pemisah recordnya adalah newline, satu peristiwa yang memakai dua belas baris berarti dua belas peristiwa. Runtime mencatat setiap baris sebagai entry tersendiri dan platform mengirimnya masing-masing, sehingga saat beban tinggi frame stack trace Anda datang berselang-seling dengan output dari dua replica lain. Lebih buruk lagi, backend yang meng-index per baris akan menaruh pesan error dan frame yang menyebut file Anda di hasil pencarian yang berbeda, padahal justru gabungan itulah yang Anda butuhkan.
// Wrong: the message goes out, then the stack goes out as its own lines.
// The platform records 12 events, none of which carry the request id.
catch (e) {
  console.error("approval failed", e);
}
// approval failed
// Error: connect ETIMEDOUT 10.42.0.19:5432
//     at TCPConnectWrap.afterConnect [as oncomplete] (node:net:1611:16)
//     ... nine more frames, interleaved with two other pods under load

// Right: one event, one line. The stack is a string field inside it.
catch (err) {
  logger.error({ err, approvalId: payload.id, step: "post" }, "approval failed");
}
// Wrapped here for the page; on the wire it is a single line:
// {"level":50,"levelName":"error","time":"2026-09-25T02:40:11.418Z",
//  "service":"erp-api","release":"a1c9f2e","traceId":"0af7651916cd43dd...",
//  "err":{"type":"Error","message":"connect ETIMEDOUT 10.42.0.19:5432",
//         "stack":"Error: connect ETIMEDOUT ... at TCPConnectWrap ..."},
//  "approvalId":"AP-90412","step":"post","msg":"approval failed"}
Aturan yang lahir dari situ lebih kaku daripada dugaan saya: tidak ada yang boleh menulis ke stdout kecuali logger. Satu console.log di mana pun akan menghasilkan baris tanpa service, tanpa release, dan tanpa trace id, sehingga tidak bisa dibedakan dari noise. Saya jadikan itu lint error, mengalihkan beberapa kasus yang memang sah lewat logger.info, dan menyisakan library pihak ketiga yang suka mencetak sendiri sebagai satu-satunya pengecualian yang saya periksa setiap kali menaikkan versi dependency.
Correlation ID adalah satu-satunya penyambung empat stream
Kegagalan yang dilihat customer hanya satu request. Buktinya tersebar di empat pod dan dua service. Tanpa identifier yang dibawa setiap baris, menyusunnya kembali berarti mencocokkan timestamp dari proses yang berbeda, dan itu tebakan yang menyamar sebagai metode. W3C Trace Context sudah mendefinisikan format di kabelnya: header traceparent berisi version, trace-id, parent-id, dan flags, dengan trace-id berupa array 16 byte yang ditulis sebagai 32 karakter hex huruf kecil dan nilai nol semua dianggap tidak valid. Memakai standar ini berarti gateway, proxy, dan vendor tracing sudah ikut mempropagasikannya untuk Anda.
// request-context.ts - one id per request, carried without threading it
// through every function signature in the codebase.
import { AsyncLocalStorage } from "node:async_hooks";
import { randomBytes } from "node:crypto";

type Ctx = { traceId: string; spanId: string };
export const store = new AsyncLocalStorage<Ctx>();

// W3C traceparent is version-traceid-parentid-flags, all lowercase hex:
// 00-0af7651916cd43dd8448eb211c80319c-b7ad6b7169203331-01
// trace-id is a 16-byte array, 32 hex chars, and all-zero is invalid.
function incomingTraceId(header?: string): string | null {
  const parts = (header ?? "").split("-");
  const id = parts[1] ?? "";
  return parts.length === 4 && id.length === 32 && !/^0+$/.test(id) ? id : null;
}

app.use((req, res, next) => {
  const traceId =
    incomingTraceId(req.header("traceparent")) ?? randomBytes(16).toString("hex");
  const spanId = randomBytes(8).toString("hex");
  // Hand it back, so a user can quote it in a support message and you can
  // find the request without knowing exactly when it happened.
  res.setHeader("x-trace-id", traceId);
  store.run({ traceId, spanId }, next);
});

// Every line now carries it, with no argument passing anywhere.
const logger = pino({ mixin: () => store.getStore() ?? {} });

// And it has to leave the process again, or the id dies at the first hop.
await fetch(paymentsUrl, {
  headers: {
    traceparent: "00-" + ctx.traceId + "-" + ctx.spanId + "-01",
  },
});
Jebakannya ada di sisi outbound. Gampang sekali menerima header itu, mencatat id-nya dengan rajin sepanjang request, lalu memanggil service payments dengan fetch polos, dan pada titik itu id-nya berhenti di hop pertama sehingga baris-baris service kedua kembali anonim. Wrapper HTTP client apa pun yang Anda pakai, taruh propagasinya di dalam wrapper itu, karena satu call site yang lupa pasti call site yang muncul saat insiden.
Buffering adalah jebakan yang menyembunyikan baris yang Anda cari
Baris hilang yang paling mahal adalah baris yang tidak sempat selesai ditulis oleh proses. Dokumentasi Node.js menyebut jelas bahwa penulisan ke process.stdout bisa sinkron atau asinkron tergantung stream itu tersambung ke apa: file bersifat sinkron di Windows dan POSIX, TTY sinkron di POSIX, sedangkan pipe dan socket asinkron di POSIX. Di dalam container stdout Anda adalah pipe di Linux, jadi Anda berada di kasus asinkron. Halaman yang sama menyebut bahwa penulisan sinkron ada antara lain supaya output tidak sampai tidak tertulis sama sekali kalau process.exit dipanggil sebelum penulisan asinkron selesai, dan dokumentasi process.exit menegaskan bahwa fungsi itu memaksa proses berhenti secepat mungkin walaupun operasi I/O ke stdout dan stderr masih tertunda.
Lalu logger Anda menambah lapisan kedua. Mode asinkron pino memang sengaja melakukan buffering, menulis dalam potongan lebih besar setelah minLength byte terkumpul, dan dokumentasinya menyebut caveat-nya terus terang: pesan yang paling baru masuk buffer bisa hilang kalau terjadi kegagalan sistem. Kedua lapisan itu berperilaku benar. Digabungkan, keduanya membuat fatal handler klasik, yang mencatat lalu langsung exit, menjadi bentuk yang persis membuang satu-satunya baris yang bisa menjelaskan crash tersebut.
// Wrong: logger.fatal returns before the bytes have left the process, and
// exit() discards pending stdout writes. The one line that explained the
// crash is the one you never see.
process.on("uncaughtException", (err) => {
  logger.fatal({ err }, "uncaught, crashing");
  process.exit(1);
});

// Right: flush first, exit inside the callback.
process.on("uncaughtException", (err) => {
  logger.fatal({ err }, "uncaught, crashing");
  logger.flush(() => process.exit(1));
});

// Better for the fatal path: a synchronous destination, so the write has
// completed before the next statement runs. It blocks the event loop, which
// is exactly what you want in a process that is about to stop existing.
const fatalLogger = pino(pino.destination({ dest: 1, sync: true }));

// Ordinary shutdown: do not call exit at all. A rolling deploy sends SIGTERM,
// and the loop drains by itself once the server is closed.
process.on("SIGTERM", async () => {
  await server.close();
  process.exitCode = 0;
});
Fatal handler yang memanggil process.exit tepat setelah logger.fatal adalah cara paling umum untuk kehilangan bukti yang paling Anda butuhkan. Masalahnya juga tidak terlihat saat development, karena di sana stdout biasanya TTY dan karena itu sinkron di POSIX. Perilakunya baru berubah begitu proses masuk ke container, yang artinya tepat ketika hal itu mulai penting.
Retention, dan pod yang mati sebelum sempat dilihat
Stream yang tidak Anda rekam bukan observability. Dokumentasi logging Kubernetes menyatakannya langsung: log seharusnya punya storage dan lifecycle yang terpisah dari node, pod, dan container, dan Kubernetes tidak menyediakan solusi penyimpanan bawaan untuk data log. Di bawahnya, kubelet merotasi log container memakai containerLogMaxSize yang defaultnya 10Mi dan containerLogMaxFiles yang defaultnya 5. Batas itu berupa ukuran, bukan durasi, sehingga pod yang cerewet bisa menggulung buktinya dalam hitungan menit sementara pod yang sepi menyimpannya seminggu. Keduanya bukan kebijakan retention yang Anda pilih.
- Level warn ke atas langsung keluar dari platform, menuju storage yang retention-nya Anda tentukan sendiri.
- Level info di-sampling, bukan dibuang, karena konteks laju request itulah yang nanti membuat satu baris error jadi terbaca.
- Level debug tidak pernah keluar dari pod, dan dinyalakan per service lewat environment variable saat memang dibutuhkan.
- Apa pun yang mungkin ditanyakan auditor sebenarnya bukan log. Itu baris di tabel audit milik ERP sendiri, di Postgres, tempat data itu bisa di-join dengan order yang dijelaskannya.
# The exported stream is newline-delimited JSON, so jq is the whole triage
# kit. Keep these three in the runbook, not in your head at 03:00.

# 1. Everything that happened to ONE request, across every service.
jq -c 'select(.traceId == "0af7651916cd43dd8448eb211c80319c")' stream.ndjson

# 2. Errors and worse, as a table you can read. In pino's numeric scale
#    error is 50 and fatal is 60.
jq -r 'select(.level >= 50) | [.time, .service, .release, .msg] | @tsv' stream.ndjson

# 3. Which release produced them. This ends more incidents than any other
#    single command, because the answer is usually the deploy from 20:00.
jq -r 'select(.level >= 50) | .release' stream.ndjson | sort | uniq -c | sort -rn
Poin terakhir yang paling sering dibantah, jadi biar jelas soal trade-nya: log itu untuk diagnosis dan boleh saja lossy, di-sampling, dan akhirnya dihapus. Riwayat approval adalah catatan bisnis. Menyimpannya hanya di log stream berarti masa hidupnya ditentukan oleh pod mana yang kebetulan cerewet minggu itu, dan tidak ada yang akan mengambil keputusan seperti itu dengan sadar.
Log stream di browser itu tail dengan scrollback, bukan index pencarian - punya Helipod, misalnya, dikirim lewat server-sent events. Pelajari jalur export-nya di sore yang santai, unduh satu stream sungguhan, dan simpan filter jq yang sudah terbukti jalan di runbook. Baru mencari tombol export saat insiden berlangsung menghabiskan sepuluh menit pertama, padahal itu sepuluh menit termurah yang Anda punya.
Web terminal itu untuk apa, dan untuk apa bukan
Web terminal menjawab satu jenis pertanyaan dengan sangat baik: apakah dunia ini sesuai dugaan saya, di dalam pod yang saat ini masih hidup. Jenis pertanyaan itu benar-benar berguna, dan mencakup sebagian besar hal yang dulu saya lakukan lewat SSH di server yang sehat.
- Membaca environment yang benar-benar diterima proses, yang tidak selalu sama dengan yang ditampilkan dashboard.
- Me-resolve nama internal service dan melakukan curl ke health endpoint-nya dari dalam jaringan cluster, tempat laptop Anda tidak bisa menjangkau.
- Melihat filesystem yang benar-benar dihasilkan build, yang biasanya menyelesaikan perdebatan soal asset hilang atau working directory yang salah.
- Memeriksa jam dan timezone container sebelum Anda menghabiskan satu jam pada timestamp yang sebenarnya tidak pernah salah.
Yang bukan tugasnya: menjadi jalan masuk ke pod yang sudah keluar, karena tidak ada proses untuk ditempeli dan container yang crash loop justru sedang tidak berjalan ketika Anda sampai. Web terminal juga bukan tempat memperbaiki apa pun. Filesystem container dibangun ulang dari image pada deploy berikutnya, dan replica baru yang ditambahkan autoscaler tidak pernah melihat perubahan Anda. Saya pernah melihat perubahan lewat web terminal bekerja sempurna sampai platform menaikkan jumlah pod menjadi dua, lalu separuh traffic kembali bertemu bug aslinya dan bukti perbaikannya tidak tersimpan di mana pun.
Checklist sebelum insiden
Tidak satu pun dari daftar ini bisa ditambahkan ketika pager sudah berbunyi. Masing-masing memakan waktu kurang dari satu jam di sore yang tenang, dan masing-masing pernah menjadi pembeda antara insiden sepuluh menit dan insiden tiga jam buat saya.
- Setiap baris adalah satu JSON object, ditulis oleh satu logger, dan console.log berstatus lint error, bukan kebiasaan.
- Error diserialisasi ke dalam baris yang sama itu, dengan stack sebagai field bertipe string, bukan dicetak sebagai blok teks tersendiri.
- Trace id masuk di edge dari header traceparent, dibuat kalau tidak ada, dikembalikan ke pemanggil lewat response header, dan diteruskan di setiap panggilan keluar.
- Setiap baris membawa service, environment, dan release SHA, sehingga tidak pernah ada baris yang anonim.
- Jalur fatal melakukan flush sebelum keluar, dan shutdown biasa mengisi process.exitCode alih-alih memanggil process.exit.
- Level warn ke atas dikirim ke luar platform, ke storage dengan retention yang Anda pilih, bukan sekadar apa pun yang kebetulan disimpan platform.
- Anda sudah pernah meng-export stream itu sekali di hari yang tenang, dan filter jq untuk membacanya tersimpan di runbook, bukan di ingatan.
Checklist ini tidak pernah terasa mendesak. Tetapi mengerjakannya juga tidak pernah lebih dari sehari, dan sehari itu selalu lebih murah daripada insidennya, karena saat insiden kode sudah beku dan apa pun yang sedang ditulis proses adalah seluruh informasi yang tersedia.
Kehilangan SSH tidak membuat production lebih sulit di-debug. Ia membuat kualitas logging saya menjadi satu-satunya variabel yang menentukan, dan itu terasa tidak nyaman, karena sebelumnya variabel tadi bisa bersembunyi di balik shell yang selalu bisa saya andalkan. Aturan yang saya pakai sekarang, sebelum sebuah service boleh mendekat ke traffic production: jelaskan seperti apa baris terburuknya nanti jam 3 pagi. Kalau jawabannya teks bebas dari pod tanpa nama, service itu belum selesai.
Sumber dan bacaan lanjutan
- Dokumentasi Node.js - process.stdout, process.exit, dan catatan tentang process I/O
- Dokumentasi Pino - asynchronous logging, buffering, dan logger.flush
- W3C Trace Context Recommendation - format header traceparent
- Dokumentasi Kubernetes - logging architecture, log rotation, dan cluster-level logging
- Helipod - log streaming lewat browser dan terminal tanpa SSH key